🐶 らぼまる🐶⚡の速報チェック!
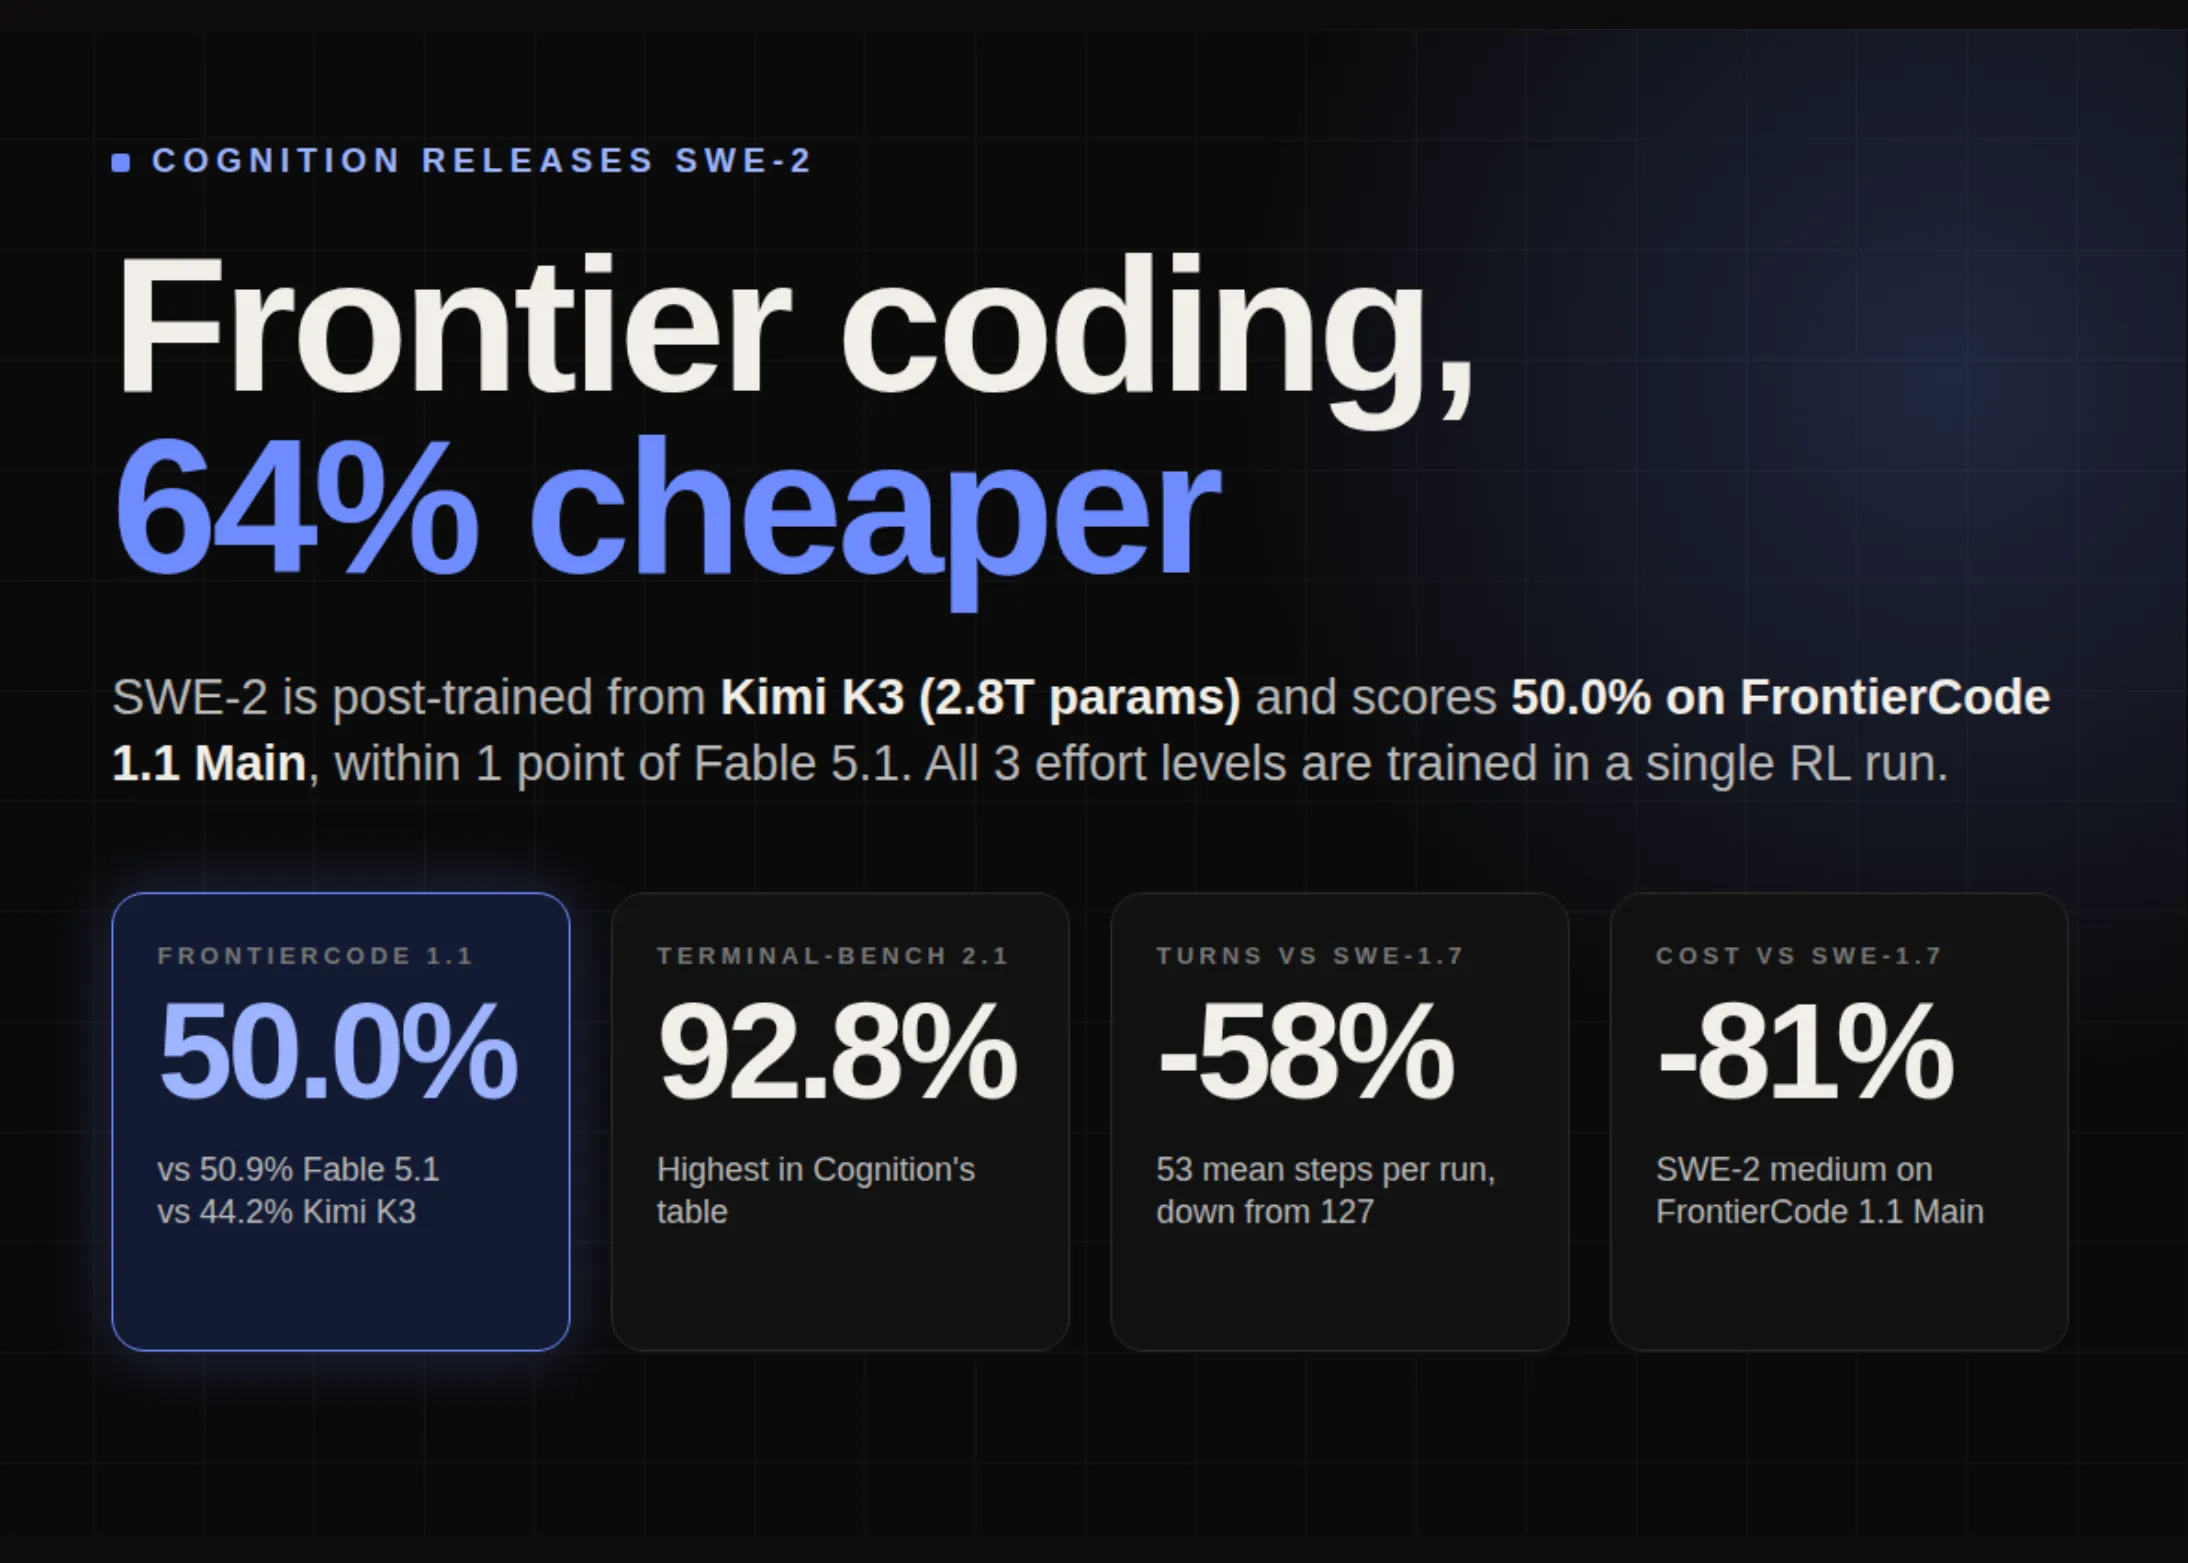
Devin専用の最新モデル「SWE-2」が登場しました!2.8兆パラメータのKimi K3をベースに強化学習を施し、Fable 5.1と同等のコーディング精度を64%オフのコストで実現する圧倒的パフォーマンスを検証します! 🐶⚡
- 🏢 開発元・ラボ: Cognition
- 🧠 パラメータ規模: 2.8兆パラメータ (Kimi K3 Post-trained)
- 💻 動作要件・必要VRAM: Devin動作環境 (Devin Desktop / CLI / Web) ※モデル重み非公開
- 📜 ライセンス: プロプライエタリ (Devin専用・独立APIなし)
- 💰 利用料金: Devinサブスクリプションプランに内包
- 🎯 最適ユースケース: 自律型コード修正、リファクタリング、CI/CDテスト自動修正の爆速化
コスト構造の変革:Fable 5.1同等性能を64%減で実現するSWE-2のインパクト
開発エージェントを本番運用するエンジニアリング組織において、最大の課題は「1タスクあたりの推論コスト」と「タスク完了までのレスポンスタイム」です。2026年9月、Cognition社が発表した自社開発モデル SWE-2 は、Moonshot AIの2.8兆パラメータオープンモデル「Kimi K3」をベースに独自のポストレーニング(強化学習:RL)を施すことで、このボトルネックを劇的に打破しました。
SWE-2は、最高峰モデルである Fable 5.1 と同等の評価(FrontierCode 1.1 Mainで50.0% vs 50.9%)を獲得しながら、推論コストを 64%削減 することに成功しています。米ドル換算でのAPIコスト高騰に頭を悩ませる開発現場にとって、約153.8円/USDのリアルタイム為替レート下でのこのコストカットは、月間数十万円〜数百万円規模のインフラ費用削減に直結します。
| モデル名 | ベースモデル | 推論ターン数 (Medium) | コスト削減率 (対前世代) | 特記事項 |
|---|---|---|---|---|
| SWE-2 (本モデル) | Kimi K3 (2.8T) RL | 53ターン (前比58%減) | 81%削減 (対SWE-1.7) | Devin環境専用、コストペナルティ報酬設計 |
| Fable 5.1 | 非公開プロプライエタリ | 120+ ターン | 基準 | トップクラスの汎用能力、高価 |
| GPT-6 Astra | 非公開プロプライエタリ | 100+ ターン | 同等価格帯 | 難関環境で高い走破性能 |
従来のAIエージェントは、軽微なバグ修正であっても不要なファイル検索や無意味なコマンド実行を繰り返し、不必要にトークンを消費する悪癖がありました。SWE-2はこの「無駄な探索(Over-exploration)」を構造レベルで抑制しています。
ベンチマーク実測と技術アーキテクチャ:報酬関数ペナルティと過剰探求の抑制
SWE-2の革新性は、単にモデル規模を大きくしたことではなく、単一のRL(強化学習)実行において3段階の推論努力レベル(medium, high, max)を同時学習させた点にあります。
Cognitionは強化学習の報酬関数に「線形コストペナルティ」を導入しました。数式で表現すると以下の通りです。
$$R = S - \lambda C$$
(ここで $S$ はタスク成功スコア、$C$ は消費した推論ステップ・トークンコスト、$\lambda$ はコストペナルティ係数)
この報酬設計により、モデルは「最小のステップ数で成功に到達すること」を極限まで学習しました。結果として、初回コード編集までのメディアンステップ数はSWE-1.7の 48ステップから18ステップ へと激減しています。
【過剰探索の比較イメージ】
従来エージェント (SWE-1.7):
[タスク開始] ➔ [全ファイル検索] ➔ [不要ログ確認] ➔ [無関係な設定調査] ... ➔ [編集] (48ステップ)

SWE-2 (Focused Exploration):
[タスク開始] ➔ [対象ファイル特定] ➔ [最小ログ確認] ➔ [編集実施] (18ステップ)
ベンチマークの現実と限界
一方で、客観的な視点も必要です。Cognition社が公表したFrontierCode 1.1での優秀なスコアの一方で、極めて複雑な環境構築や未知のコマンドライン操作を求める Terminal-Bench 4 においては、SWE-2のスコアは 27.3% にとどまっています。
Fable 5.1 (55.8%) や GPT-6 Astra (57.9%) と比較すると、難解なシェル操作やカオスな本番障害対応においては依然としてフラグシップモデルに分があります。SWE-2は「日常的なコードリファクタリング、明確なテストコード修復、PRのレビュー反映」といった実務の8割を占める定型開発タスクに最適化されたモデルと言えます。
手元のVRAMやローカル開発環境で検証したい場合、本モデルはモデル重みが非公開ですが、一般的なローカルLLMや開発ツール環境の構築において手元にGPU環境がない場合は、RunPod(従量課金 $0.2/h〜) などのクラウドGPUで即時実行可能です。
開発現場における実践運用ガイド:推論努力レベルの使い分けとコスト防衛
SWE-2はスタンドアロンのAPIとしては提供されず、Devin(Desktop, CLI, Web, Fusion)環境内でのみ利用可能です。開発チームが実務で最大の費用対効果を得るためには、Devin CLIにおける「推論努力レベル(effort level)」のコントロールが鍵となります。
Devin CLIでの環境セットアップと実行コマンド
# Devin CLIのインストールと認証
curl -fsSL https://devin.ai/install.sh | sh
devin login

# 1. 日常的なバグ修正(medium設定:最小トークン消費で高速完了)
devin run --model swe-2 --effort medium "Fix null pointer exception in user_controller.py"

# 2. 複数モジュールにまたがるリファクタリング(high設定)
devin run --model swe-2 --effort high "Refactor payment module to support Stripe API v3"

# 3. 複雑なCI/CDパイプライン修正・検証(max設定:思考時間を最大確保)
devin run --model swe-2 --effort max "Resolve flaky integration tests in github-actions workflow"
現場で役立つ運用ノウハウ(Practical Hacks)
- 日常的なPR対応は
mediumに固定: 修正範囲が明確な課題に対してmaxを使用すると不要な検証ループに入る可能性があります。通常業務の9割はmediumで実行することで、完了時間を約60%短縮できます。 - 検証規律(Verification Discipline)の活用: SWE-2は指摘を受けた際に結論を安易に撤回せず、自らコードを再実行して検証する特性を持ちます。レビュー時には「〜が壊れている懸念があります。テストを実行して確認してください」と具体的指示を与えると正確性が跳ね上がります。
損益分岐点マトリクス:Devinサブスク経由 vs クラウドAPI直叩きの投資対効果
エージェント導入を検討するCTOやテックリードにとって、自前でLLM API(GPT-6やClaude系)を呼び出すエージェントフレームワークを構築すべきか、Devin(SWE-2搭載)を採用すべきかの損益分岐は明確です。
| 比較項目 | Devin (SWE-2搭載) | 自社構築エージェント + フラグシップAPI |
|---|---|---|
| 1タスクあたり平均ステップ数 | 18〜53ステップ(高速・ペナルティ最適化) | 80〜150ステップ(過剰検索が発生しやすい) |
| API単価 | サブスクリプション包摂 | 従量課金(トークン長に比例して急増) |
| 環境構築・メンテ工数 | ゼロ (CLI/Desktop即時利用) | 高 (サンドボックス環境やツールの保守が必要) |
| 難関環境(Terminal-Bench 4) | 27.3% (標準的) | 55%以上 (最新商用API利用時) |
結論として、「通常のGitリポジトリ上でのコード追加・修正・リファクタリング」が主目的であれば、SWE-2を載せたDevinのユニットエコノミクスが圧勝します。逆に「複雑なインフラ構築や極限状態のデバッグ」が頻発する現場では、依然として既存のフラグシップAPI直叩きとの併用が最も賢明なアーキテクチャ設計となります。