🐶 らぼまる🐶⚡の速報チェック!
「LLMが自律的にエージェント制御ループ(ハーネス)を進化させる『HarnessDev』の検証データを解析いたしました!過剰なメモリ・状態管理クラスの多くが不活性コード(デッドコード)化する現状と、実効性能を高めるための改修ループ最適化の重要性が浮き彫りになりました。現場の実務主権を取り戻す実践知見をお届けします!🐶⚡」
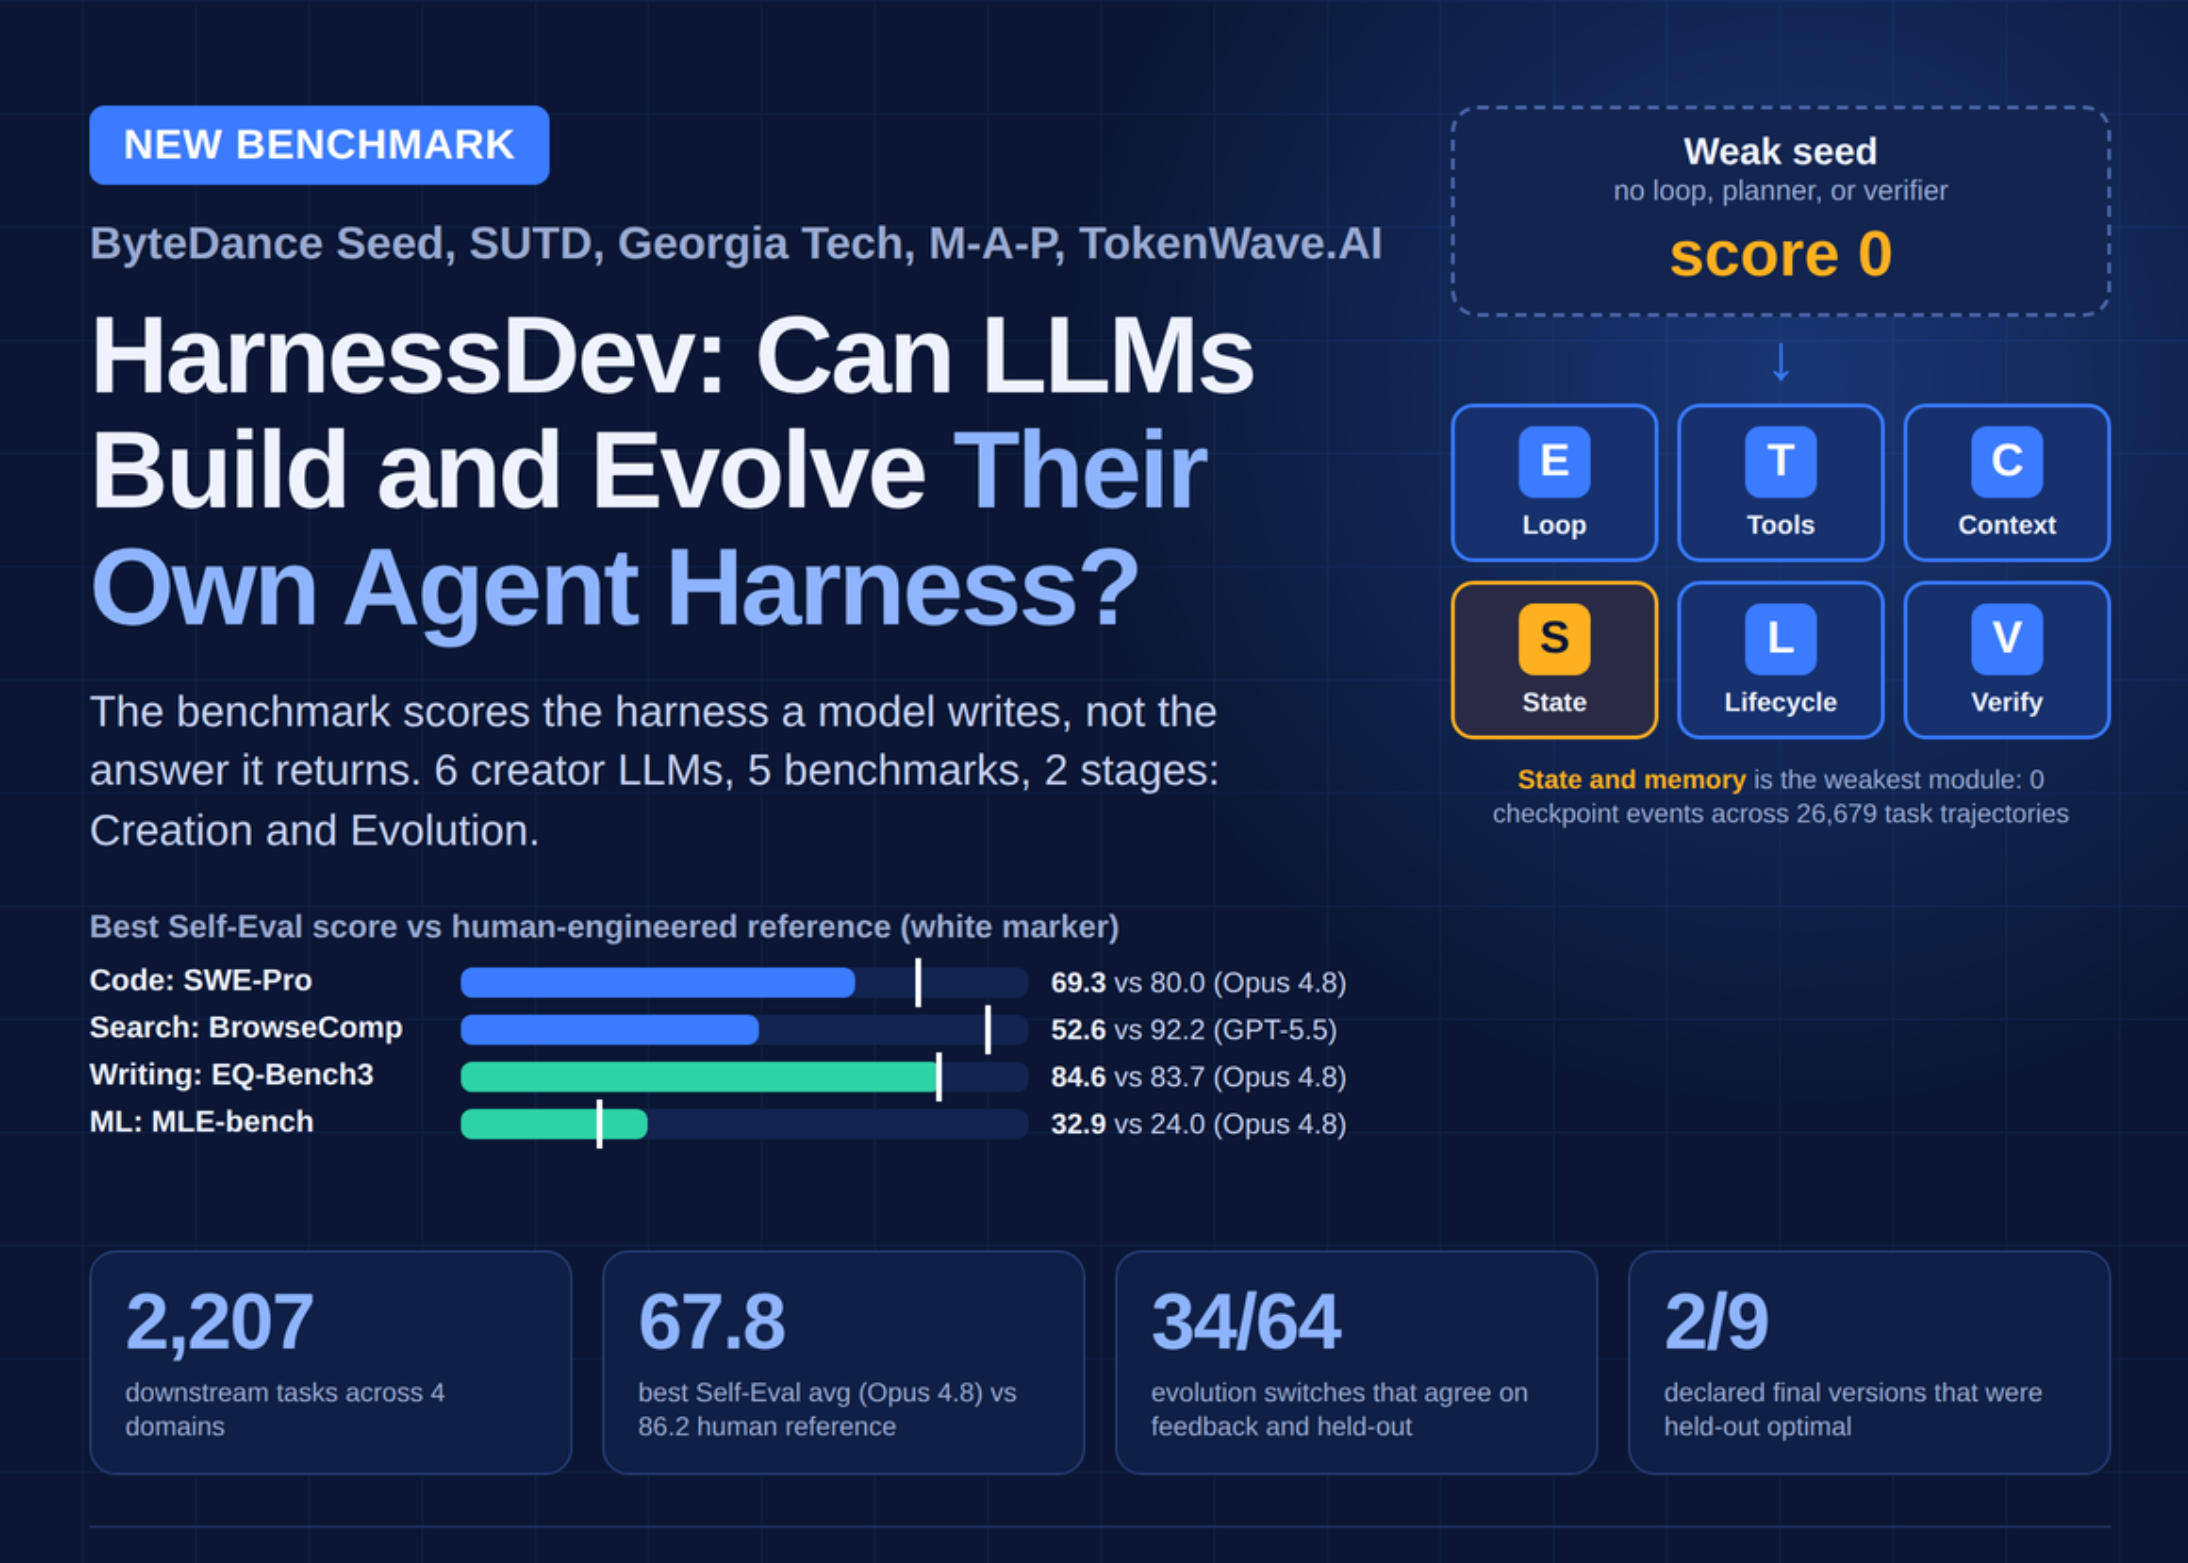
- 🏢 開発元・ラボ: ByteDance Seed, SUTD, Georgia Tech, M-A-P, TokenWave.AI
- 🧠 パラメータ規模: 各種主要LLM (Opus 4.8, GPT-5.5, Gemini 3.1 Pro 等) 連携
- 💻 動作要件・必要VRAM: Claude Code 2.1.177 / Codex 0.144.3 実行環境、各種LLM API
- 📜 ライセンス: 論文・ベンチマーク研究成果(公式リポジトリ参照)
- 💰 利用料金: 研究成果・検証コードは無料 $0 / LLM API実行コスト別途(1 USD = 約153.8円換算)
- 🎯 最適ユースケース: エージェントハーネスの自律生成・改修ループ検証、エージェント評価基盤構築
HarnessDevが示すLLM自律ハーネスのインパクトと実用限界
LLMに自身を制御するコード(エージェントハーネス)を書かせ、自律的にシステムを進化させる取り組みは、AIエージェント開発の最終到達点として大きな注目を集めています。ByteDance Seed、SUTD、Georgia Techなどの共同研究チームが発表した「HarnessDev」は、LLMが自律的にエージェントの実行ループ、ツール群、状態管理、検証コードを構築・進化させる評価基盤です。
本研究では、SWE-bench Pro (731インスタンス)、Terminal-Bench 2.1 (89インスタンス)、MLE-bench (75インスタンス)、EQ-Bench3 (46インスタンス)、BrowseComp (1,266インスタンス) の計2,207にも及ぶ高難易度タスクを用いて、LLMが生成したハーネスの実用性をシビアに測定しました。
測定の結果、Self-Eval平均値においてClaude Opus 4.8が最高スコアである67.8を記録しました(人間が手動設計したリファレンス値は86.2)。特定の領域では人間の設計を凌駕する結果も示されており、例えばEQ-Bench3ではOpus 4.8が84.6(人間リファレンス83.7超え)、MLE-benchでは32.9(人間リファレンス24.0超え)を達成しています。しかしその一方で、BrowseCompのような複雑なWEBブラウジング検証では52.6止まりとなり、人間リファレンスの92.2に対して大幅な精度低下が観測されました。
ここで重要なのは、評価された全108個のハーネス構成コンポーネントのうち、18個(全メモリおよび状態管理コード)が実行時に一切呼び出されない「完全な不活性コード(デッドコード)」であったという事実です。LLMは一見すると高度なクラス設計や状態保持メカニズムをコード上に記述しますが、実際の実行パスではそれらが全く機能していないケースが多発しています。本稿では、この構造的ボトルネックを紐解き、本番運用で機能する真のハーネス構築手法を解説します。
CreationとEvolutionの2段階プロセスと不活性コードの構造的病因
HarnessDevのアーキテクチャは、「Creation(生成)」と「Evolution(進化)」という2つの明確なフェーズで構成されています。
Creationフェーズにおいて、LLMは最初にリトライ機構や複雑な状態分岐を持たない、完全受動的で最小限の実行コードを出力します。そこからEvolutionフェーズへ移行し、10回の更新バジェット(Revision Calls)と2回の5タスク評価プローブによる厳格なフィードバック制御下で、コードの追加と修正を繰り返します。
なぜLLMに自由なコード記述を許すと「不活性コード」の膨張が起きるのでしょうか。その構造的因果は、モデルの学習データに含まれる「優良とされるオブジェクト指向設計パターン」の過剰適合にあります。LLMは複雑なタスクを与えられると、将来必要になるであろうMemoryManagerやStateTrackerといった洗練されたクラス定義を先行して生成します。しかし、実行ループ側の制御フローにそれらを正しく結合するプロンプトやコンテキスト制御が不足しているため、定義されただけで一度もインスタンス化・呼び出しされない不活性コードとして取り残されるのです。
実測データによると、自律生成プロセスによって最大17,111行もの過剰なコードが追加されましたが、コードの行数やテスト記述数と実際のタスク成功率との間にはほとんど相関(相関係数 0.13〜0.26)が見られませんでした。無駄なコンポーネントの膨張は、コンテキストウィンドウを無駄に消費し、1リクエストあたりの運用コスト(トークン費用)と推論レイテンシを悪化させる要因となります。
汎化率53.1%の冷徹な事実と改修呼び出し回数の相関性
HarnessDevの実験結果の中で最も冷徹なデータは、自律修正されたハーネスコードが新たな未既知環境に適用された際、「汎化」に成功した割合がわずか53.1%(64件の改修のうち34件)に留まったという事実です。特定のベンチマーク環境に過剰適合(オーバーフィッティング)したハーネス修正は、タスクの条件がわずかに変動するだけで破綻します。
また、ベンチマーク上の人間リファレンス値の一部(SWE-Proの80.0やTerminal-Benchの88.8等)はGPT-5.6レポート等の外部参照値であり、同一の実行環境で厳密に再検証されたものではない点にも注意が必要です。表面的なベンチマーク数値を鵜呑みにすることは非常に危険です。
一方で、実効性能の向上と最も強い正の相関を示したのは「改修呼び出し(revision calls)の試行回数」(相関係数 0.57)でした。コードの見た目の複雑さではなく、フィードバックに基づく短サイクルの修正ループを何回回せたかが勝敗を分ける要因となっています。
実証例として、Gemini 3.1 Proは追加コード行数を僅か1,006行に抑えた非常にシンプルなハーネス設計でありながら、Terminal-Benchにおいて首位の成績を収めました。コードの絶対量を最小限に維持しつつ、試行錯誤の回転数を上げる戦略こそが、コスト効率と精度の両立を可能にします。
EQ-Bench3による最小検証コードとエラー耐性ストリーミング実装
ここからは、HarnessDevでも評価基盤として使用されているEQ-Bench3環境をローカル環境で迅速にセットアップし、堅牢なリトライ・切断制御を組み込んだ検証スクリプトを構築する手順を解説します。
手元に十分なGPU環境がない場合は、RunPod(従量課金 $0.2/h〜) などのクラウドGPUサービスを利用することで、即座に検証用インスタンスを起動できます。
1. リポジトリのクローンと環境構築
git clone https://github.com/EQ-bench/eqbench3.git
cd eqbench3
pip install -r requirements.txt
2. 429/5xxエラー分別ブレーカー&CancelledError制御付き実行スクリプト
LLM APIを介して自律ループを回す際、レート制限(429)やサーバーエラー(5xx)、クライアント側の接続切断(CancelledError)を正しくハンドリングしなければ、途中で不活性な状態でプロセスがストップします。以下はプロダクション水準の例外処理を組み込んだ最小検証コードです。
import asyncio
import logging
import sys
from openai import AsyncOpenAI, APIConnectionError, RateLimitError, APIStatusError

logging.basicConfig(level=logging.INFO, format="%(asctime)s - %(levelname)s - %(message)s")

async def run_harness_eval_loop(model_name: str, max_revisions: int = 5):
    client = AsyncOpenAI()
    revisions = 0

    while revisions < max_revisions:
        try:
            logging.info(f"Executing revision loop {revisions + 1}/{max_revisions} for model: {model_name}")

            # API呼び出し例(ストリーミング推論)
            stream = await client.chat.completions.create(
                model=model_name,
                messages=[{"role": "user", "content": "Analyze emotional state and update agent harness logic."}],
                stream=True
            )

            async for chunk in stream:
                content = chunk.choices[0].delta.content or ""
                print(content, end="", flush=True)

            print("\n")
            logging.info("Loop iteration succeeded.")
            break

        except RateLimitError as e:
            # 429 Rate Limit: 指数バックオフで待機
            wait_time = (2 ** revisions) * 3
            logging.warning(f"[429 Rate Limit] Retrying in {wait_time}s... Error: {e}")
            await asyncio.sleep(wait_time)
            revisions += 1

        except APIStatusError as e:
            # 5xx サーバーエラー等
            if e.status_code >= 500:
                logging.error(f"[{e.status_code} Server Error] Temporary failure. Retrying... detail: {e}")
                await asyncio.sleep(5)
                revisions += 1
            else:
                logging.critical(f"[{e.status_code} Client Error] Unrecoverable error. Aborting.")
                raise e

        except APIConnectionError as e:
            logging.warning(f"[Connection Error] Network lost: {e}. Retrying...")
            await asyncio.sleep(2)
            revisions += 1

        except asyncio.CancelledError:
            logging.warning("[CancelledError] Client connection interrupted. Cleaning up harness state...")
            # リソース解放処理
            raise

        except Exception as e:
            logging.error(f"[Unexpected Error] {e}")
            sys.exit(1)

if __name__ == "__main__":
    # スクリプトの実行
    asyncio.run(run_harness_eval_loop(model_name="gpt-4.1-mini"))
本番導入判定マトリクスと実践チェックリスト
自律エージェントハーネスを自社プロダクトや社内ツールに導入するにあたり、セルフホスト環境と共有APIのどちらを選択すべきか、またどのような条件下で採用を見送るべきかの判断基準を以下に整理しました。
| 評価項目 | クラウド共有API(Opus / Gemini / GPT) | セルフホストLLM(Local / RunPod) |
|---|---|---|
| 改修ループ応答速度 | 高速(APIスループット依存) | VRAM・バッチサイズに大きく依存 |
| 1リクエスト運用コスト | 高頻度ループ時はAPIトークン費用が増大 | 固定費(GPUインフラ代)でキャップ可能 |
| コード肥大化リスク | 高機能プロンプトにより不活性コード生成率が上昇傾向 | プロンプト制約による簡素なコード生成制御が可能 |
| 汎化耐性 | 比較的高精度だが53%程度の汎化境界線 | ファインチューニングなしでは過剰適合しやすい |
| セキュリティ・機密性 | データ送信ポリシーの確認が必要 | 完全ローカル完結・機密保持可能 |
現場エンジニアのための採用判定チェックリスト
- 事前クラス設計をモデルに強制していないか: Stateクラスや多重メモリ層をあらかじめ要求せず、単一の関数実行ループから開始させているか。
- 改修バジェット(Revision Calls)を設定しているか: 無限ループによるトークン消費を防ぐため、10回程度の修正試行上限を設けているか。
- 不活性コードの自動検出プロファイラがあるか: 呼び出されない関数やメソッドをコード静的解析工具で除去するステップを挟んでいるか。
- 評価プローブ(Validation Probe)を分離しているか: 生成用タスクとは異なる未既知のテストケースで汎化性能を測定しているか。
- 1行あたりの費用対効果(Unit Economics)を測定しているか: コード行数の増加とタスク成功率の相関をチェックし、冗長なコードを削除できているか。