📅 2026-09-14 18:36 • Reddit r/LocalLLaMA 【先行検証】DeepSeek V4.1 Flashの実装検証:100万トークン21.5円でGoogle Astraを凌駕するMoEの運用境界線 解説記事を読む ↗
📅 2026-09-13 07:53 • Reddit r/LocalLLaMA 33Bマルチモーダル「Agnes-3.0-Flash」徹底検証:AAスコア36の実力と自社ホストのコスト損益分岐点 解説記事を読む ↗
📅 2026-09-12 18:54 • Editorial / Deep Dive 【Qwen2.5-Coder-32B-Instruct】24GB VRAMという「所有の幻想」を粉砕しローカル開発基盤の現実を突きつける物理的リセットボタン 解説記事を読む ↗
📅 2026-09-12 12:09 • Reddit r/LocalLLaMA AI特有の定型句を脱却するQwen3.8-27B-Humanlike-Chatの正体:業務タスク切り捨てで到達した自然対話モデル(完全無料/ローカル動作) 解説記事を読む ↗
📅 2026-09-12 07:53 • MarkTechPost AI 商用翻訳の常識を覆す218B MoE:Cohere『North Small Translate』の構造解剖と実務導入ライン 解説記事を読む ↗
📅 2026-09-11 19:58 • Reddit r/LocalLLaMA QwenのPrefill処理を劇的に高速化:Gemini Flash型KVキャッシュ圧縮の完全検証 [完全無料] 解説記事を読む ↗
📅 2026-09-10 22:00 • Tutorial & Guide RunPod Fast-Docker 実践導入ガイド──ポッド起動を15秒に短縮し「pipフリーズ」を撲滅する設定手順【画面スクショ解説】 解説記事を読む ↗
📅 2026-09-10 21:45 • Tutorial & Guide RunPod Guardian 完全導入&使い方ガイド──3分でできるストレージ課金対策と1クリック削除【画面スクショ解説】 解説記事を読む ↗
📅 2026-09-09 21:40 • Tech Verification RunPodで「停止したのに課金が続く」を防ぐ方法──ストレージ放置課金の罠と52文字フレーズ自動入力【Chrome拡張】 解説記事を読む ↗
📅 2026-09-09 12:25 • MarkTechPost AI NVIDIAのCUDA Rust解禁!GPUカーネル開発におけるメモリ破壊バグを型で防ぐ仕組みと実用性の真価 解説記事を読む ↗
📅 2026-09-09 08:20 • Reddit r/LocalLLaMA DeepSeek Flash 4.1 API順次公開:超低レイテンシと低コストを両立する最新モデルの実装検証 解説記事を読む ↗
📅 2026-09-08 08:21 • Reddit r/LocalLLaMA MiniCPM5-2Bの実用性検証:VRAM 2GBで動作するエッジLLMの量子化限界と運用コスト最適化 解説記事を読む ↗
📅 2026-09-07 12:27 • Reddit r/LocalLLaMA Qwen 3.8 27Bの検閲解除モデル8種を徹底検証!167 GPU時間から見えた最適化と実務リスク 解説記事を読む ↗
📅 2026-09-07 08:04 • MarkTechPost AI ColQwen2.5級の精度を260Mで実現!H Companyの視覚言語エンコーダ「NeoMME」徹底検証 解説記事を読む ↗
📅 2026-09-06 21:10 • Tech Verification RunPodで環境構築時に「pip installがフリーズする」根本原因と対策【実証ログ・再現手順付き】 解説記事を読む ↗
📅 2026-09-06 20:06 • MarkTechPost AI UC Berkeleyが「CUA-Lite」を公開!KVM不要のコンテナ基盤でOSWorldのメモリ78%削減・並列度4.6倍を実現 解説記事を読む ↗
📅 2026-09-05 21:57 • Reddit r/LocalLLaMA 2004年のSony PSPで90M LLMが動作!32MB RAMの限界を突破したSub-2-bit量子化とC推論エンジンの凄絶ハック 解説記事を読む ↗
📅 2026-09-05 22:40 • Reddit r/LocalLLaMA 24GB VRAMで動く実用LLMの到達点「Qwen3.8-27b」検証:月数十万のAPIコストを0円化するローカル運用術 解説記事を読む ↗
📅 2026-09-05 22:46 • MarkTechPost AI Perplexityが放つMac専用推論エンジン「Lily」解剖|Qwen3.6-35Bを爆速化するRust+Metal特化設計 解説記事を読む ↗
📅 2026-09-05 22:48 • Reddit r/LocalLLaMA 104GB大型AIを48GB Macで爆速駆動!Qwen3.8-Flash-Nextに学ぶ極限量子化とローカル推論の到達点 解説記事を読む ↗
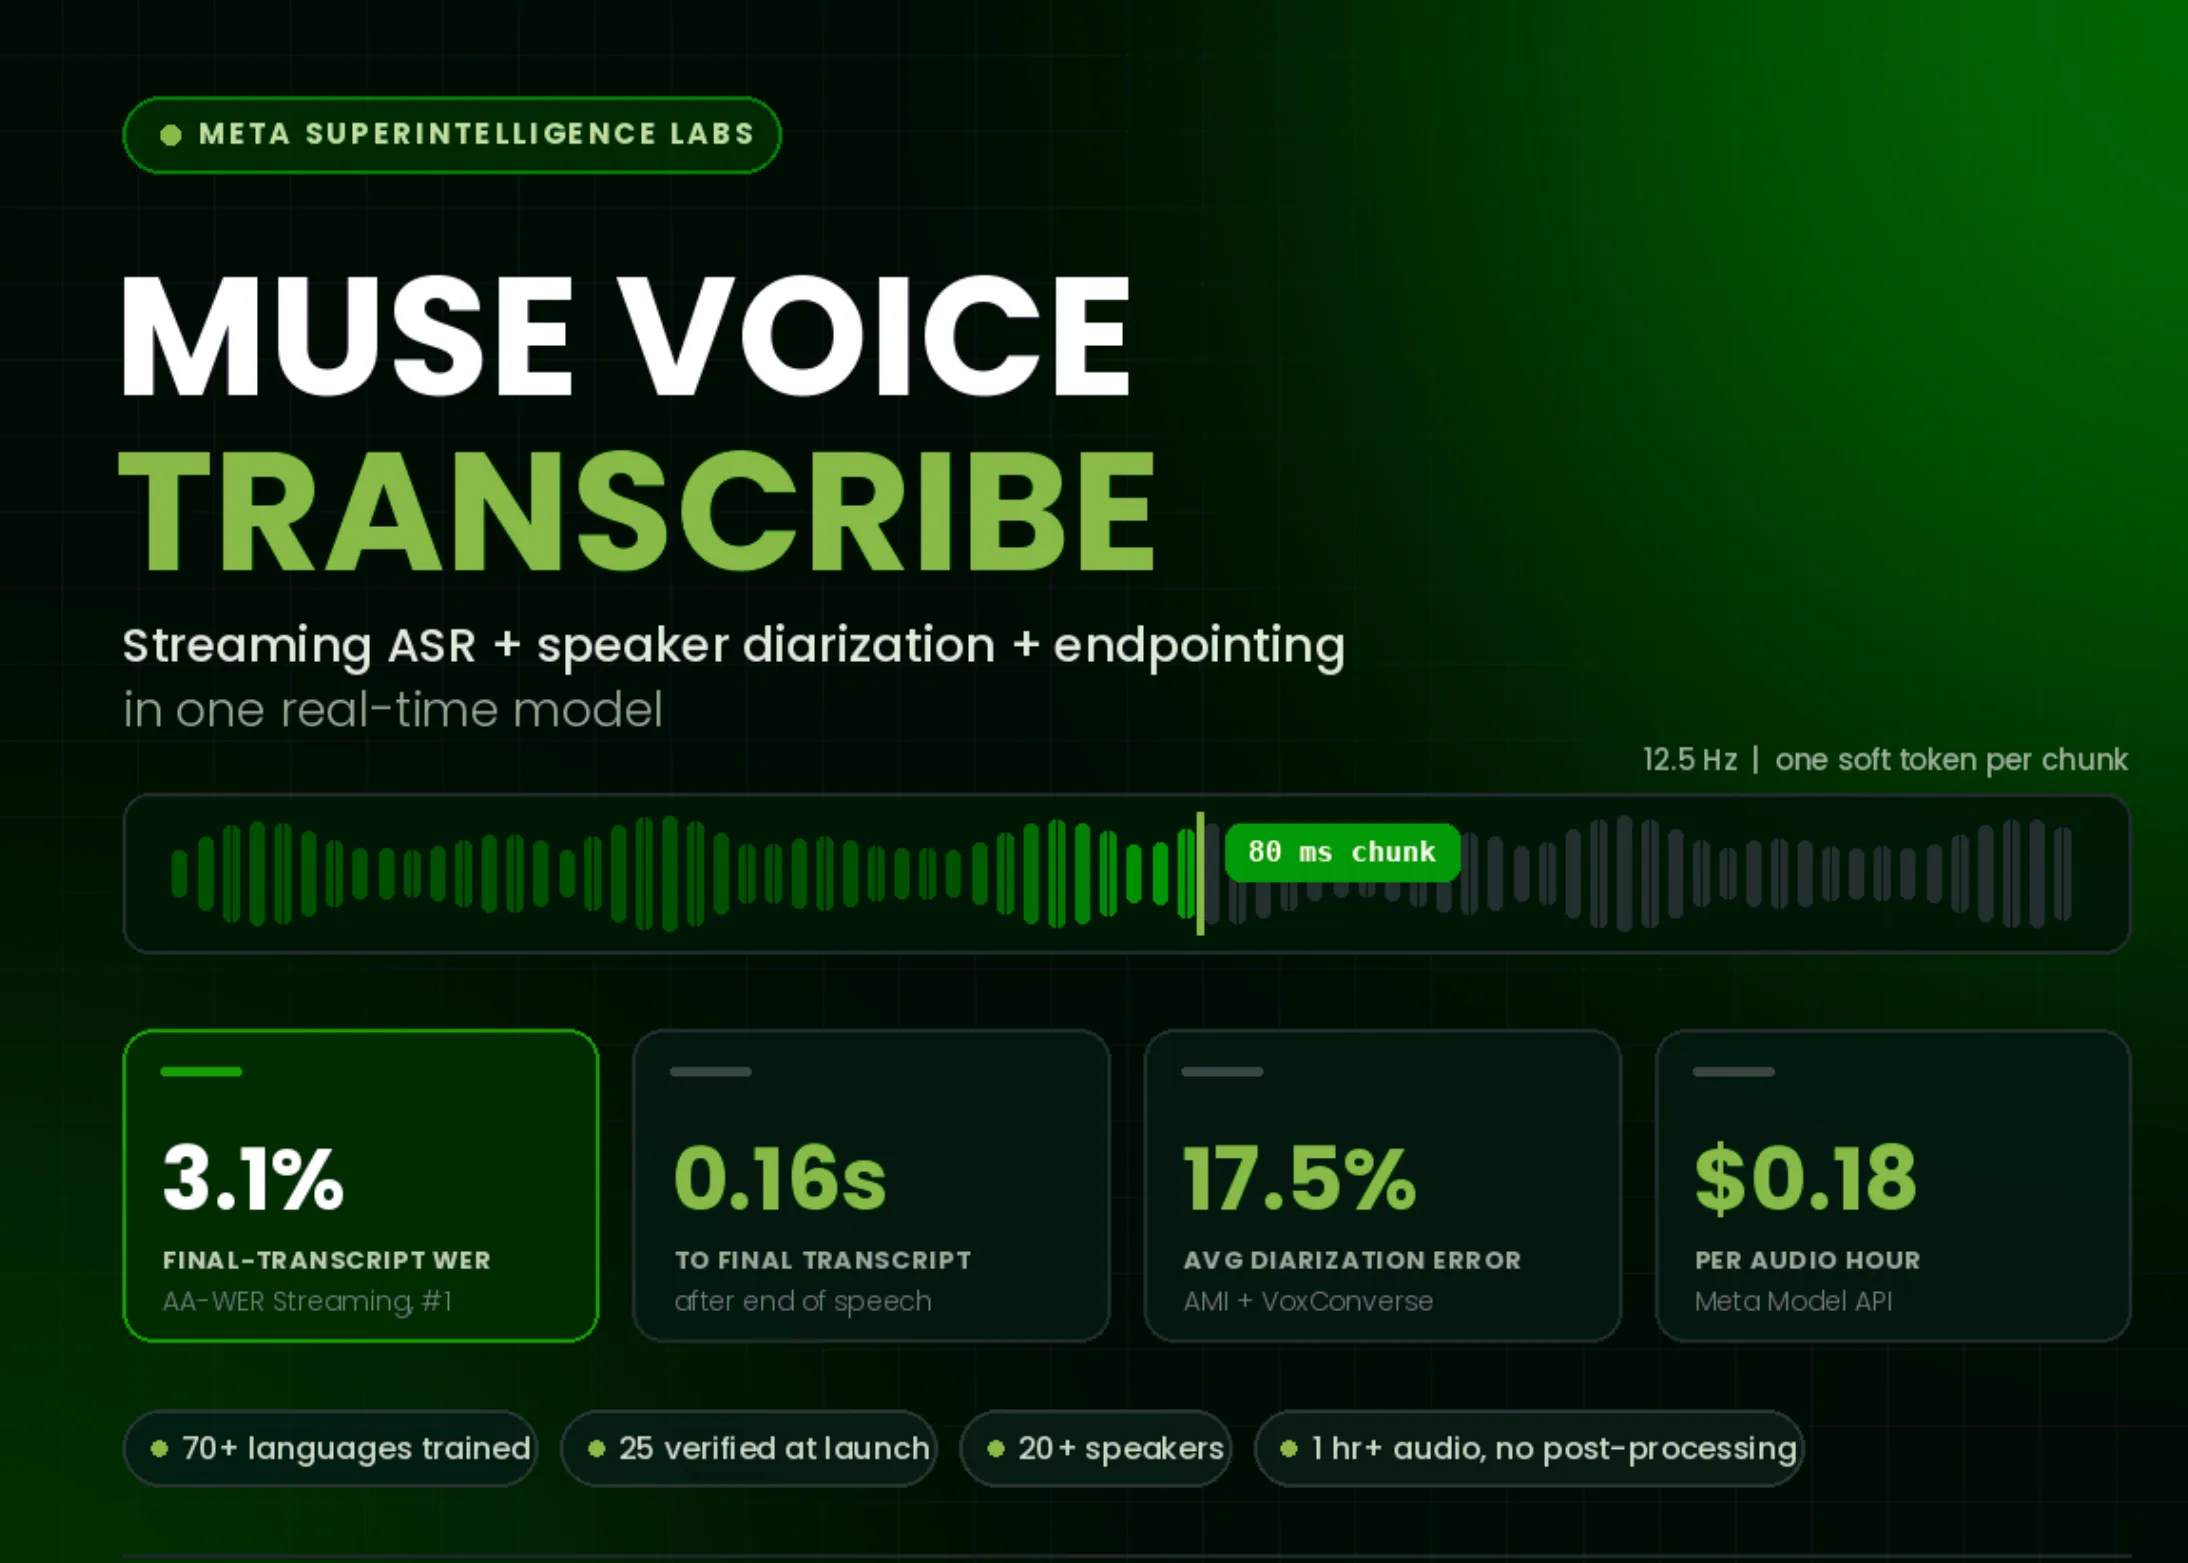
📅 2026-09-05 22:33 • MarkTechPost AI Meta『Muse Voice Transcribe』統合リアルタイム音声APIの性能と実稼働コストを徹底検証 解説記事を読む ↗
📅 2026-09-02 12:19 • Reddit r/LocalLLaMA Qwen3.8-Flash-Next-GGUFがMTPに対応!ローカルLLMの推論効率を高める注目の最新アップデート 解説記事を読む ↗
📅 2026-09-01 08:13 • Reddit r/LocalLLaMA ローカルAIで3D空間を自動構築!GLM 5.3とBlenderMCPによるペントハウス生成の実証例 解説記事を読む ↗
📅 2026-08-31 20:18 • Reddit r/LocalLLaMA DeepSeekの最新実験モデル「DeepSeek-V4-Flash-Vision-Exp」がHugging Faceに登場!次世代マルチモーダルAIの動向を解説 解説記事を読む ↗
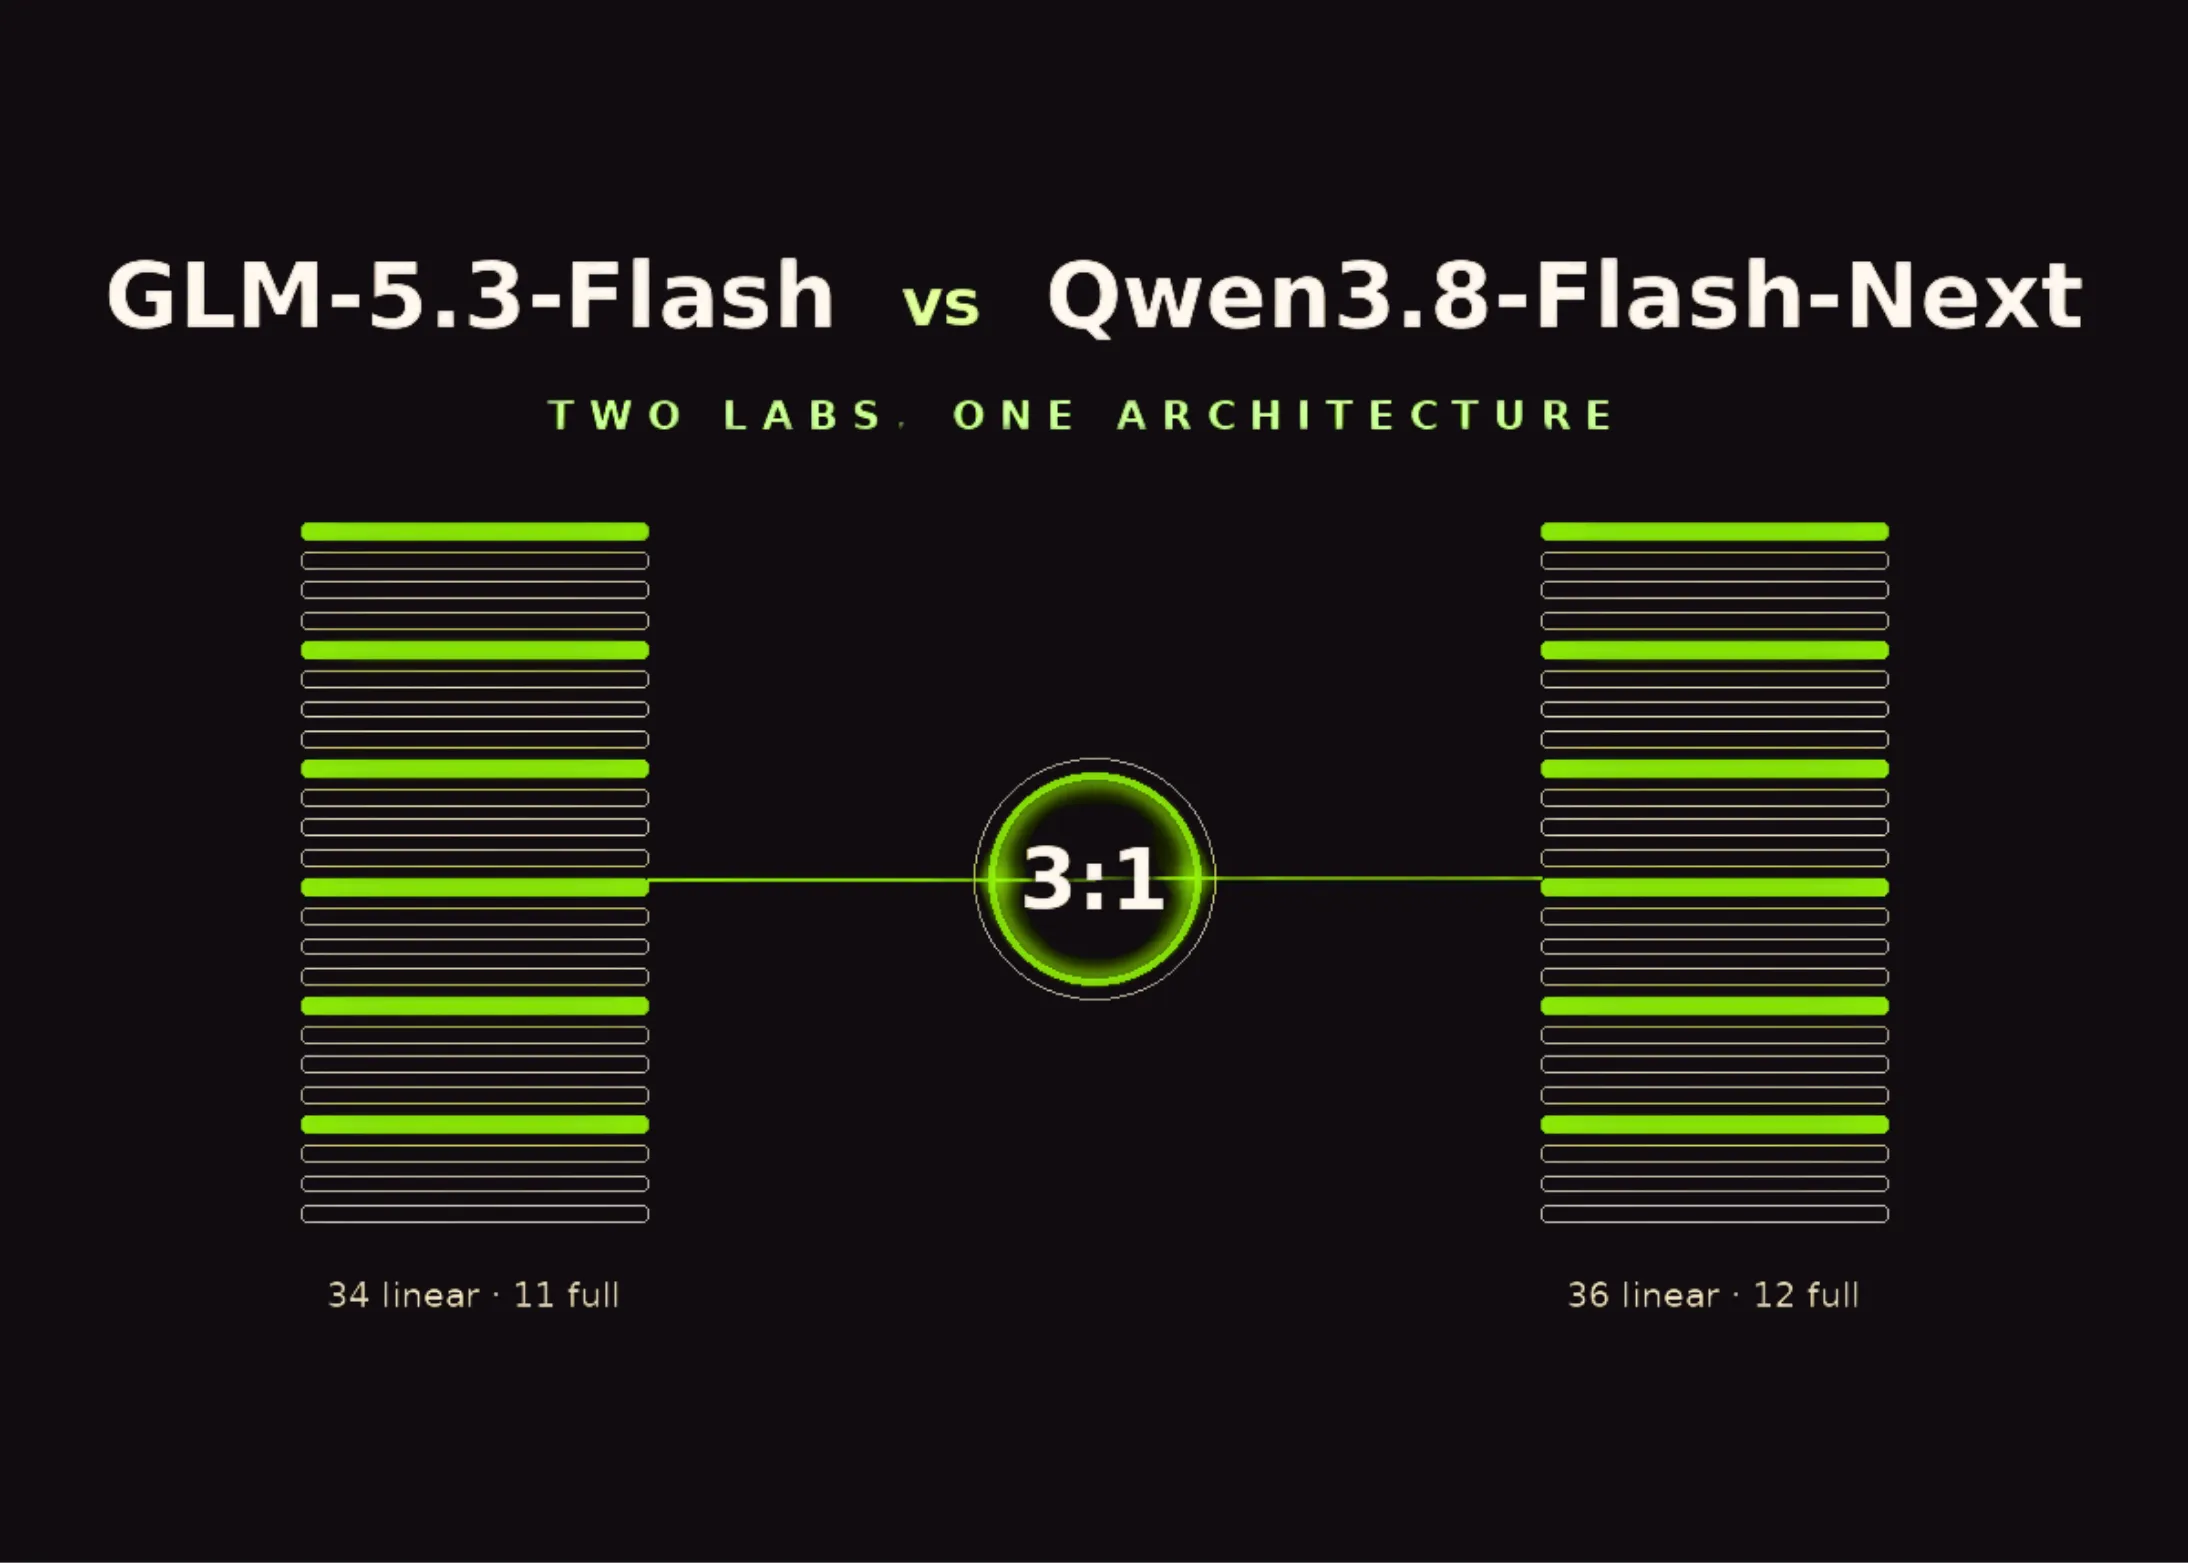
📅 2026-08-31 12:20 • Reddit r/LocalLLaMA 【LocalLLaMA話題】Qwen 3.8 Flash Next vs GLM 5.3 Flash!コミュニティによる非公式比較評価を解説 解説記事を読む ↗
📅 2026-08-31 08:16 • MarkTechPost AI 動画から物理コードを自動生成!MirroSのオープンソースAI「Code-as-World」で3Dシミュレーション開発が激変 解説記事を読む ↗
📅 2026-09-05 22:31 • Reddit r/LocalLLaMA 16GB GPUで27Bモデルが50tok/s!Qwen 3.8×beellama.cppによる100k長文ローカル推論導入ガイド 解説記事を読む ↗
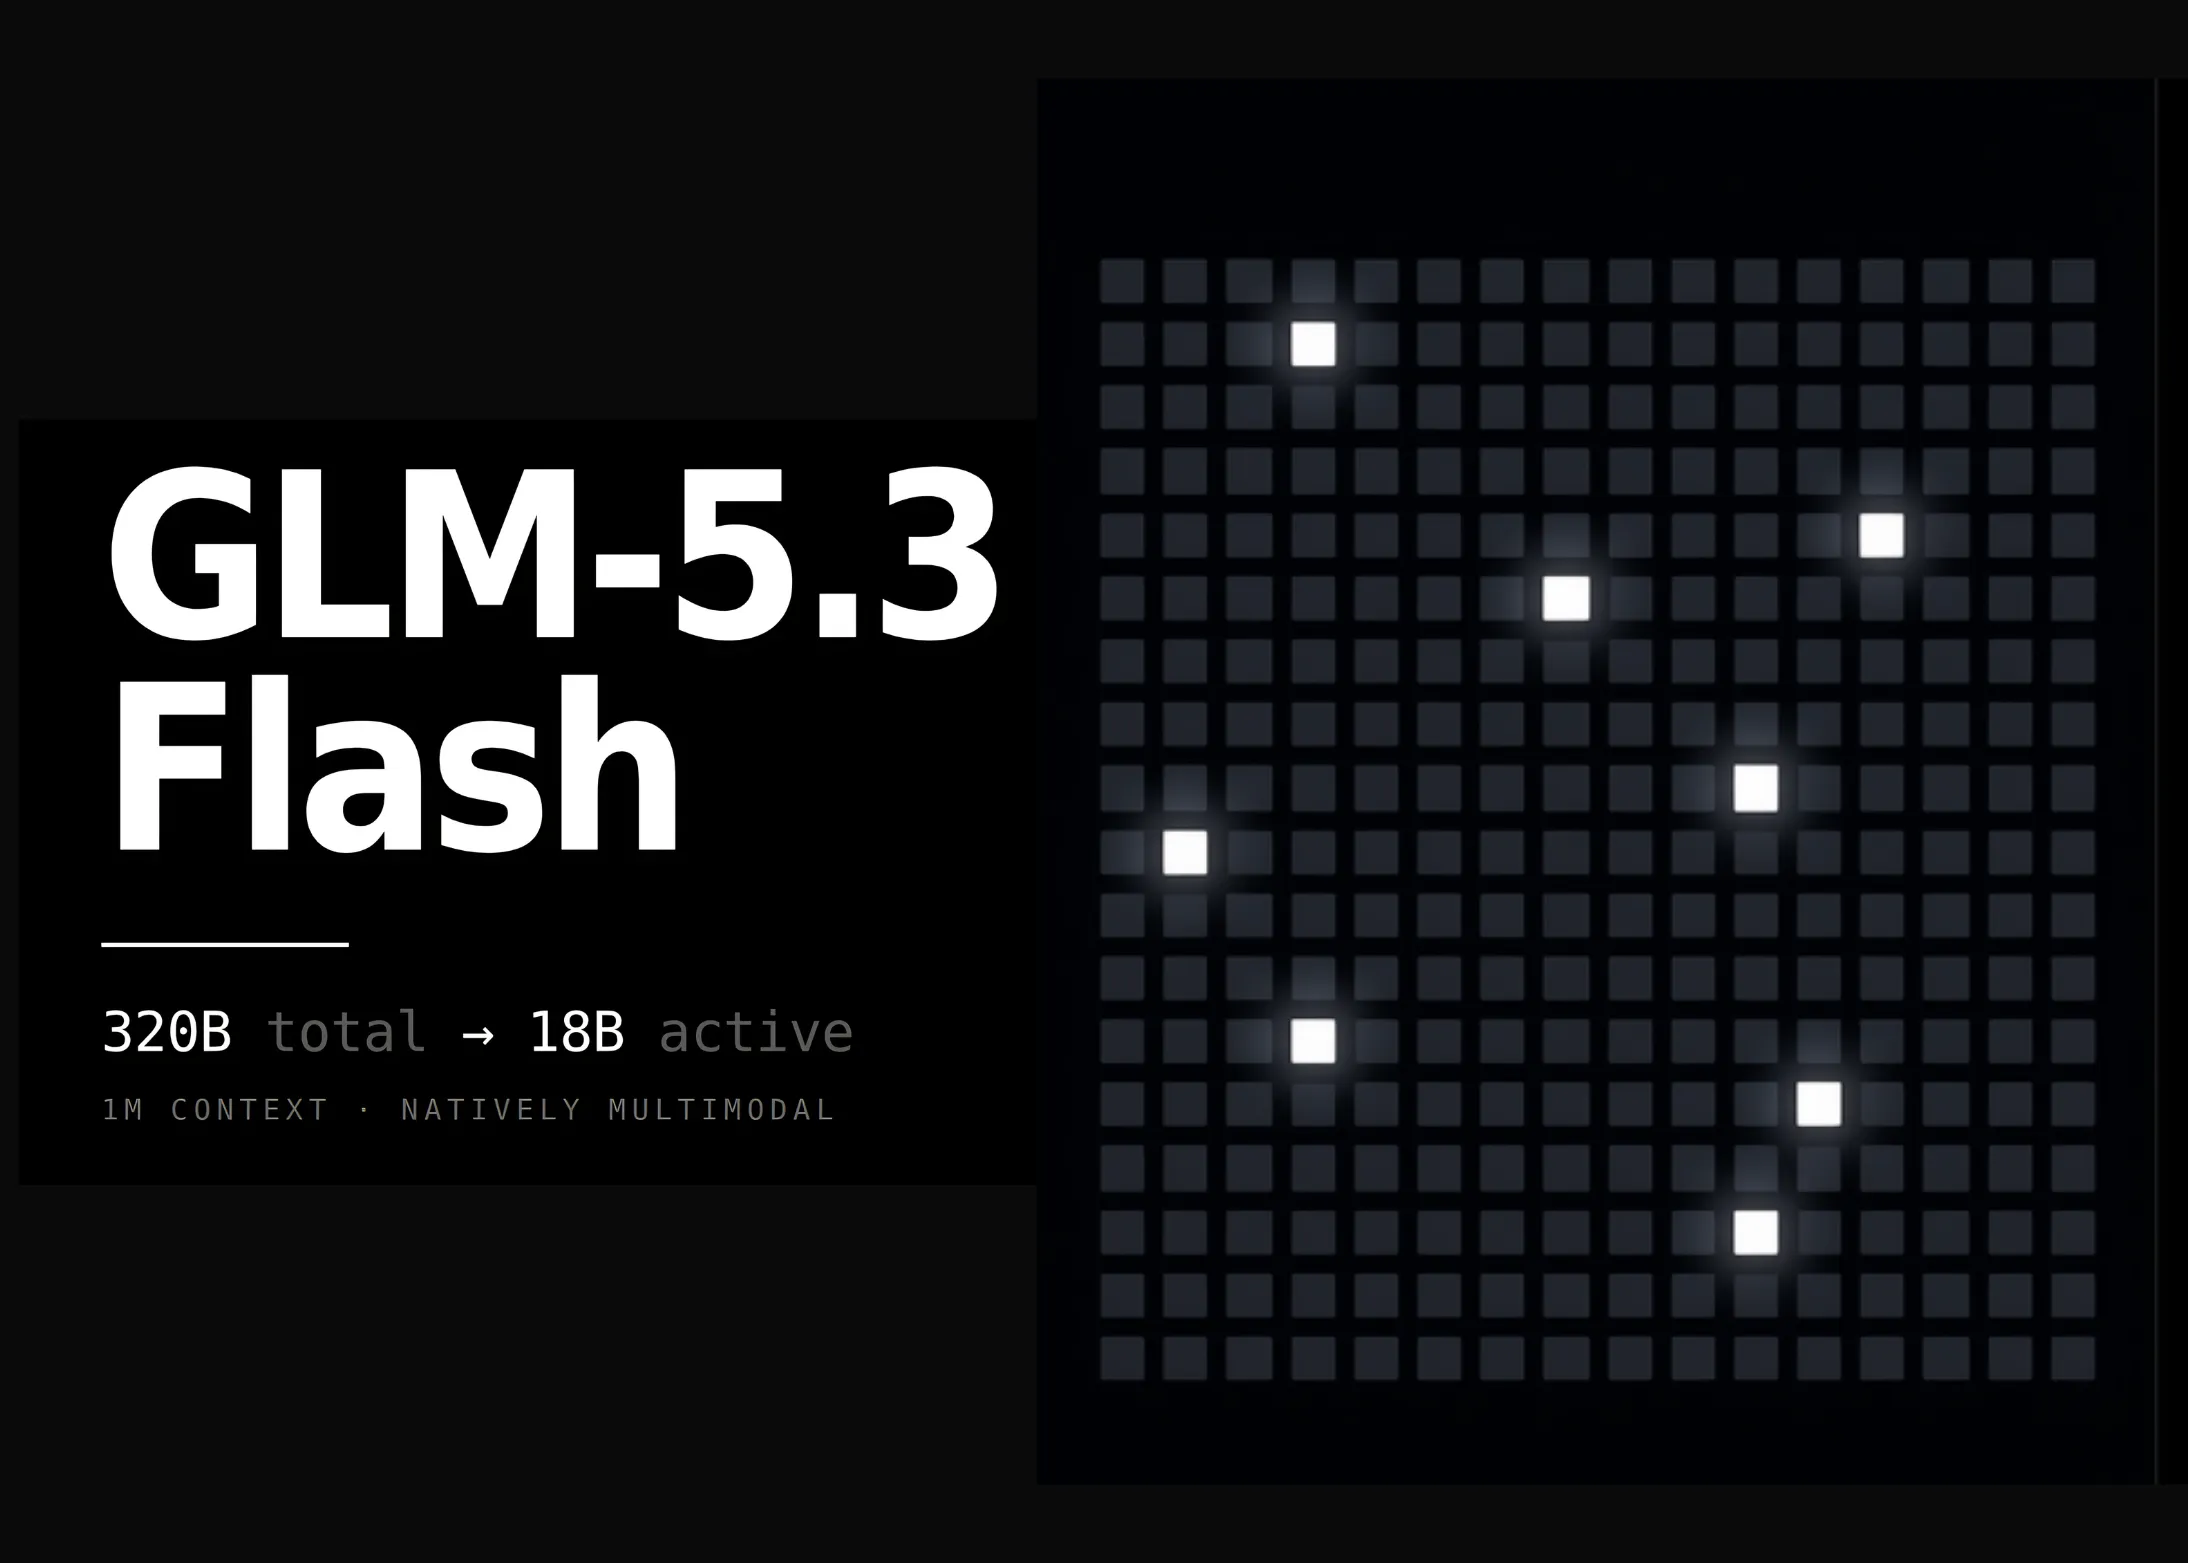
📅 2026-08-29 20:10 • MarkTechPost AI 爆速オープンAI「GLM-5.3-Flash / Qwen3.8-Flash-Next」登場!Claude並み高精度を1/10コストで運用する技術 解説記事を読む ↗
📅 2026-08-29 08:01 • Reddit r/LocalLLaMA Hugging Faceに話題の最新モデル「GLM-5.3」が登場!zai-org公開リポジトリの概要とローカル動向を徹底解説 解説記事を読む ↗
📅 2026-08-28 08:28 • Reddit r/LocalLLaMA 【話題のモデル】「Qwen3.8-Flash-Next」はDeepSeek V4 Proを超えるか?ローカルAIコミュニティの期待と注目ポイント 解説記事を読む ↗
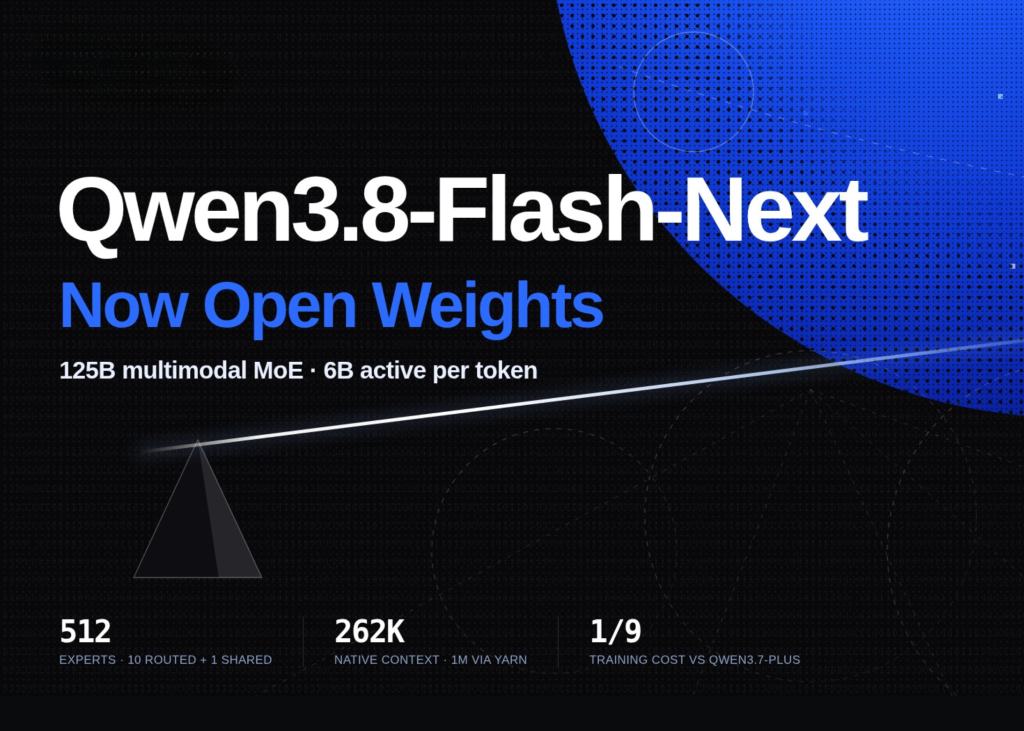
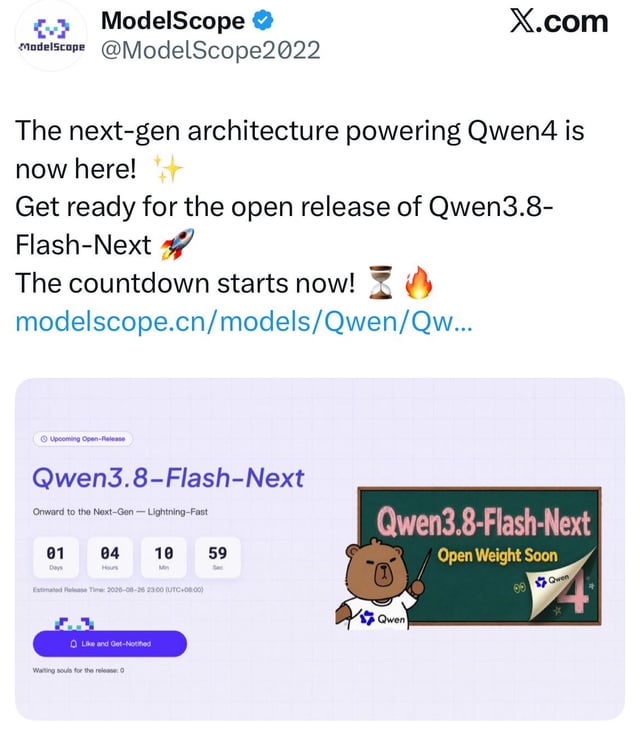
📅 2026-08-27 08:12 • MarkTechPost AI 125B級AIが6B並の軽さで動く!Qwen3.8-Flash-Next登場で爆速マルチモーダル環境を手に入れよう 解説記事を読む ↗
📅 2026-08-26 20:09 • Reddit r/LocalLLaMA 最大512GBメモリ搭載!M5 Ultra Mac Studio登場で超巨大AIのローカル完全無料運用が現実化 解説記事を読む ↗
📅 2026-08-26 12:21 • Reddit r/LocalLLaMA 次世代軽量AI「Qwen3.8-Flash-Next」解説!一般的な自宅PCで超高速ローカルAIが動く理由 解説記事を読む ↗
📅 2026-08-26 08:10 • Reddit r/LocalLLaMA Unslothが即日対応!Qwen 3.8 FlashをローカルGPUで超爆速&省VRAMで動かす実践ガイド 解説記事を読む ↗
📅 2026-08-25 21:43 • Reddit r/LocalLLaMA 爆速ローカルAI「Qwen3.8-Flash-Next」導入ガイド!RTX3060でGPT-4o級の推論を実現 解説記事を読む ↗
📅 2026-08-24 20:55 • MarkTechPost AI 753B超巨大AIが単一GPUで爆速動作!「FreeToken」で劇的に変わるローカル推論とコスト削減の未来 解説記事を読む ↗
📅 2026-08-18 20:07 • Hacker News (topstories) VRAM不足でAIが落ちない!Linux 7.3のGPUオーバーコミット強化でローカルLLM・画像生成が劇的安定化 解説記事を読む ↗