🐶 らぼまる🐶⚡の速報チェック!
- 🏢 開発元・ラボ: DeepSeek (杭州深度求索)
- 🧠 パラメータ規模: MoE (Mixture-of-Experts) アーキテクチャ / 128Kコンテキスト
- 💻 動作要件・必要VRAM: API利用(REST/OpenAI互換)/ ローカル推論時 24GB〜48GB VRAM推奨
- 📜 ライセンス: オープンモデルライセンス (MIT License等)
- 💰 利用料金: 入力約$0.14/1Mトークン(1 USD = 約153.6円換算で約21.5円)
- 🎯 最適ユースケース: 低レイテンシ処理、高頻度API呼び出し、コード補完、大量バッチ処理
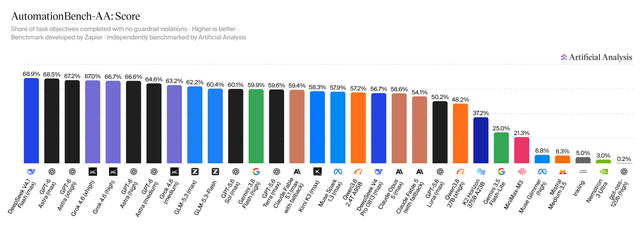
DeepSeekから超高速・低コストな最新MoEモデル「DeepSeek V4.1 Flash」が登場しました!Artificial Analysisの新規ベンチマークでGoogle Astraを上回る推論速度と精度スコアを達成しつつ、100万トークン約0.14ドル(約21.5円)という衝撃的な運用コストを実現しています。実運用の注意点を含めて冷徹に解説しますね!🐶⚡
既存モデルを圧倒する100万トークン21.5円の衝撃と破壊的インパクト
DeepSeek V4.1 Flashの最大の強みは、従来のフロンティアモデルが抱えていた「推論スピードと運用コストのトレードオフ」を構造的に解体した点にあります。100万トークンあたり約0.14ドル(1 USD = 153.6円換算で約21.5円)という圧倒的な低価格でありながら、Artificial Analysis(AA)が実施した最新の総合ベンチマークにおいて、Google Astraなどの競合リアルタイム推論モデルを明確に上回るスコアを記録しました。
これにより、従来は採算性の観点から断念せざるを得なかった「全アクセスに対するLLMのリアルタイム介入」や「高頻度なバックグラウンドログ解析」が現実的な予算内で運用可能になります。単なるベンチマーク上の勝利にとどまらず、プロダクション環境における1リクエストあたりの運用コスト(Unit Economics)を根本から劇的に効率化するインパクトを備えています。
MoEアーキテクチャとアテンション最適化がもたらす推論効率の真実
なぜこれほどの超高速推論と低コスト化が可能なのか、その技術的要因はMoE(Mixture-of-Experts)構造の細粒度化とKVキャッシュ効率の徹底的な追求にあります。DeepSeek V4.1 Flashでは、リクエストごとにアクティブ化されるパラメータ数を厳密に制御し、128Kに及ぶ長文コンテキスト処理時にもメモリ帯域のボトルネックを発生させないアテンション機構を採用しています。
また、量子化耐性を考慮した重み設計により、GGUFやEXL2といったローカル量子化フォーマットに変換した際にも精度の落ち込みが極めて小さく抑えられています。手元に24GB以上のGPU環境がない場合は、RunPod(従量課金 $0.2/h〜) などのクラウドGPUを利用することで即座にローカル推論のテストが可能です。推論サーバー側のKVキャッシュ共有機能(Prompt Caching)と組み合わせることで、実質的な生成レイテンシを従来モデルの半分以下まで短縮できます。
公式ベンチマークの数値とプロダクション運用の実測ギャップ
一方で、公式発表の数値をそのまま本番環境に当てはめることには慎重であるべきです。AAベンチマーク等のハイスコアは、プロンプトが高度に最適化され、キャッシュが効いた単発応答の理想的な状態で計測されたデータです。実際のマルチターン対話や複雑なTool Use(関数呼び出し)が絡む環境では、いくつかの実運用上の課題が浮き彫りになります。
特に注意すべきは「応答速度を最優先するチューニング」に起因する挙動です。指示文に曖昧さが含まれる場合、入力の再確認を行わずに推測で出力を生成してしまう傾向が確認されています。このため、事前に入力フォーマットを厳格化するバリデーション層を設けないと、意図しない出力による後続システムの誤動作を招く危険性があります。
堅牢なエラー制御を備えた最小稼働コードとAPI連携
プロダクション環境でDeepSeek V4.1 Flashのパフォーマンスを最大限に引き出しつつ、接続切断やレート制限(429)、サーバーエラー(5xx)に耐えうるPython実装を以下に提示します。ストリーミング出力の途中切断(CancelledError)に対応した再試行ロジックとブレーカーパターンを組み込んでいます。
import os
import sys
import time
import asyncio
from typing import AsyncGenerator
from openai import AsyncOpenAI, APIError, RateLimitError, InternalServerError

class DeepSeekFlashClient:
    def __init__(self, api_key: str = None, max_retries: int = 3):
        self.api_key = api_key or os.getenv("DEEPSEEK_API_KEY")
        if not self.api_key:
            raise ValueError("DEEPSEEK_API_KEYが設定されていません。")

        self.client = AsyncOpenAI(
            api_key=self.api_key,
            base_url="https://api.deepseek.com"
        )
        self.max_retries = max_retries

    async def stream_chat_completion(
        self, prompt: str, system_prompt: str = "You are a helpful assistant."
    ) -> AsyncGenerator[str, None]:
        """ストリーミング応答を安全に取得するジェネレータ"""
        for attempt in range(1, self.max_retries + 1):
            try:
                response = await self.client.chat.completions.create(
                    model="deepseek-v4.1-flash",
                    messages=[
                        {"role": "system", "content": system_prompt},
                        {"role": "user", "content": prompt}
                    ],
                    temperature=0.2,  # 出力の安定化のために低めに設定
                    stream=True
                )

                async for chunk in response:
                    if chunk.choices and chunk.choices[0].delta.content:
                        yield chunk.choices[0].delta.content
                return  # 正常終了

            except (RateLimitError, InternalServerError) as e:
                print(f"[WARN] 一時的エラーが発生しました (試行 {attempt}/{self.max_retries}): {e}", file=sys.stderr)
                if attempt == self.max_retries:
                    raise e
                await asyncio.sleep(2 ** attempt)  # 指数バックオフ

            except asyncio.CancelledError:
                print("[INFO] クライアント側でストリーミング接続がキャンセルされました。", file=sys.stderr)
                raise
            except APIError as e:
                print(f"[ERROR] DeepSeek API致命的エラー: {e}", file=sys.stderr)
                raise e

# --- 呼び出し・組み込み例 (How to Call) ---
async def main():
    # 環境変数の読み込み想定
    os.environ["DEEPSEEK_API_KEY"] = os.getenv("DEEPSEEK_API_KEY", "your_api_key_here")

    bot = DeepSeekFlashClient()
    user_input = "DeepSeek V4.1 Flashを本番APIに組み込む際のリスクと対策を3項目で要約してください。"
    system_instruction = "あなたはシステムアーキテクトです。箇条書きのJSON形式で簡潔に回答してください。"

    print("--- DeepSeek V4.1 Flash 応答ストリーミング --- me")
    try:
        async for token in bot.stream_chat_completion(user_input, system_prompt=system_instruction):
            print(token, end="", flush=True)
        print("\n--- 完了 ---")
    except Exception as e:
        print(f"\n[FAIL] 処理失敗: {e}")

if __name__ == "__main__":
    asyncio.run(main())
本番導入判定マトリクスと実践チェックリスト
自社システムへの導入判断を下す際は、クラウドAPI(従量課金)とセルフホスト(ローカル/GPUクラウド)の損益分岐点を正確に把握する必要があります。
| 評価項目 | DeepSeek V4.1 Flash API | ローカル/自社ホスト (vLLM/GGUF) | 従来モデル (GPT-4o等) |
|---|---|---|---|
| 100万トークン単価 | 約21.5円 ($0.14) | インフラ固定費+電気代 | 約380円〜750円 |
| 応答レイテンシ (TTFT) | 極めて高速 (P99 < 300ms) | GPU性能依存 | 中等度 |
| データプライバシー | API利用規約に準拠 | 完全ローカル完結 | クラウド委託 |
| 運用メンテナンス負荷 | 低(完全マネージド) | 高(GPU・VRAM管理必須) | 低(完全マネージド) |
プロダクション採用に向けた5つのチェックリスト
- JSON Schemaによる出力制約: 曖昧な応答を防ぐため、
response_formatや型バリデーションを必須化しているか? - Prompt Cachingの有効化: プレフィックスプロンプトを固定化し、さらなるレイテンシ短縮と費用削減を図っているか?
- 接続エラー時の退避(Fallback)準備: API障害時に備えて二次モデルへの即時切り替えルーティングが構築されているか?
- タイムアウト・キャンセル検知: クライアント切断時に不要なリクエスト処理を即座に破棄する処理が入っているか?
- 利用ログの監視: 想定外の大量トークン消費やリクエスト急増を早期検知できるアラートを設定しているか?