🐶 らぼまるの速報チェック!
「Metaから単一のデコーダーループで文字起こし・話者分離・文末検出を同時に処理する『Muse Voice Transcribe』が登場しました!従来のように複数のマイクロサービスをパイプライン接続する必要がなくなり、ストリーミング音声処理の構成を劇的にシンプル化できる点が非常に興味深いですね。現場での実装イメージと運用効率について冷徹に検証していきます!🐶⚡」
- 🏢 開発元: Meta Superintelligence Labs
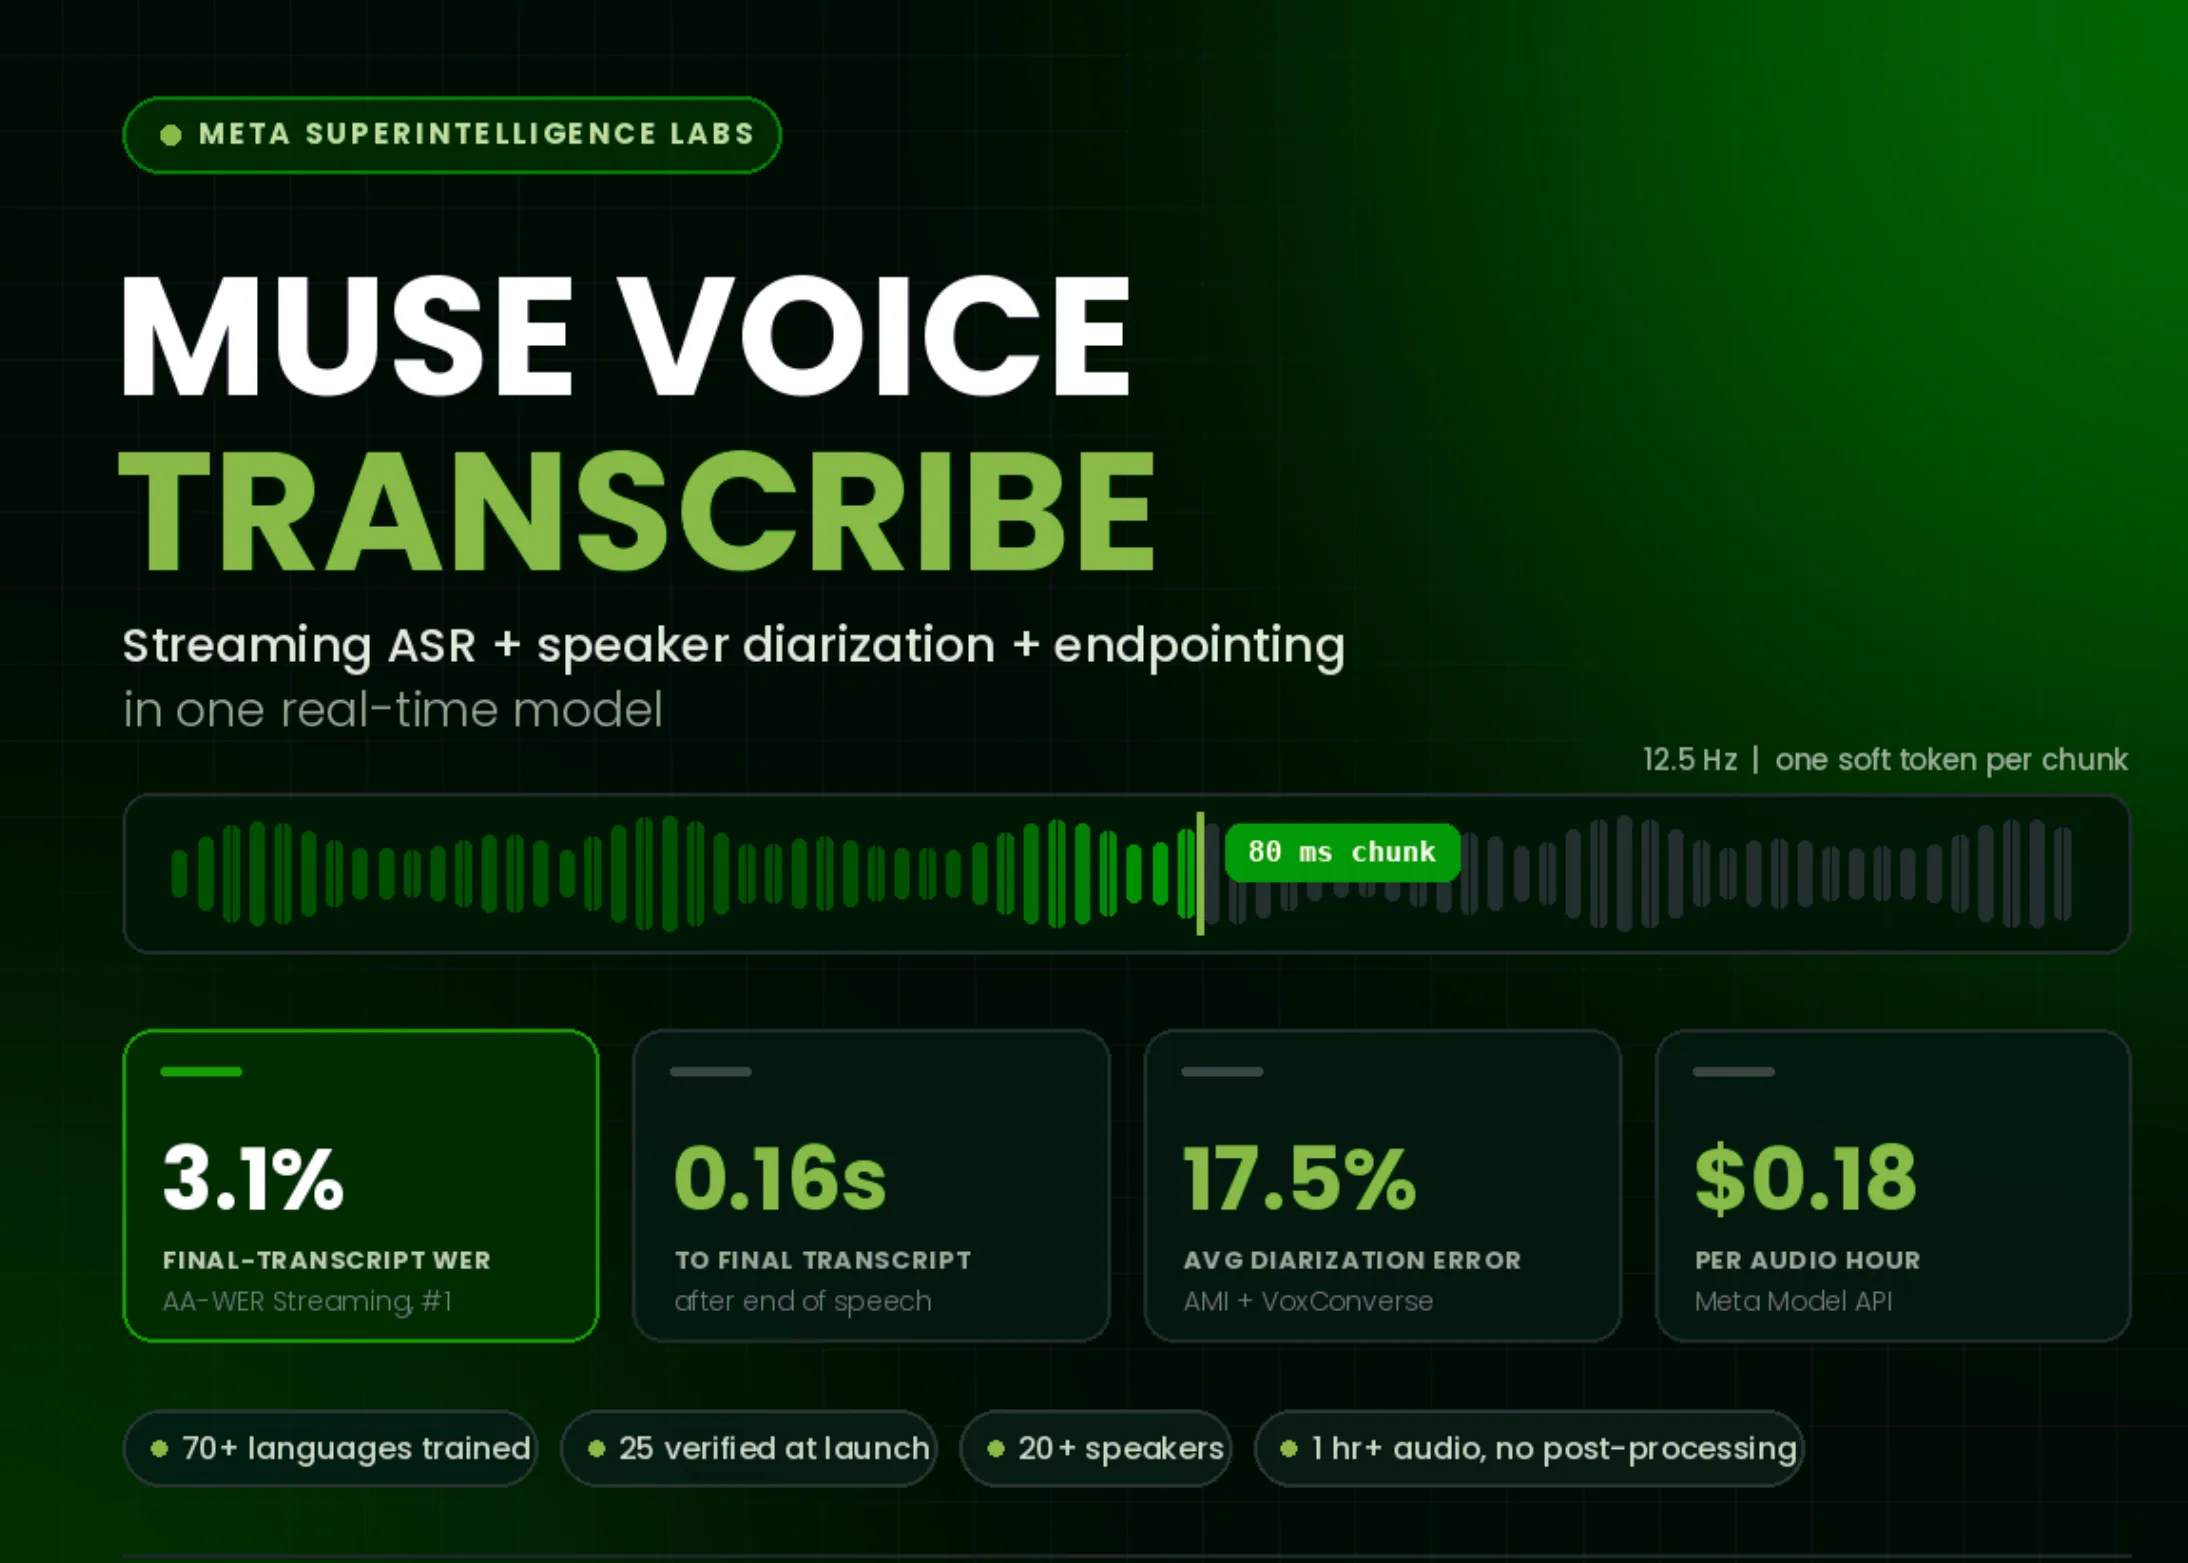
- 🧠 アーキテクチャ: Muse Sparkベース 自己回帰型マルチモーダル(80msチャンク / 12.5Hz)
- 💻 提供形態: Meta Model API(モデルウェイト非公開・クラウドAPI限定)
- 💰 利用料金: $3.00 / 1,000音声分(1時間あたり約28.1円 [1 USD = 約156.2円換算])
- 🎯 統合機能: リアルタイムASR + 話者分離(20人以上対応) + 発話終端検出(Endpointing)
要点サマリー(結論)と実務インパクト
従来、リアルタイムの対話型AIやストリーミング音声解析システムを構築する際、エンジニアは「VAD(発話区間検出)」「ASR(音声認識)」「Diarization(話者分離)」の3系統のモデルを別個に準備し、遅延やエラーハンドリングに気を配りながらパイプラインを組む必要がありました。
2026年9月1日にリリースされた muse-voice-transcribe-1.0 は、これらの処理を単一の自己回帰型デコーダーループに集約したモデルです。80ms(12.5Hz)の短い音声チャンク単位で入力を行い、1パスで「テキストトークン生成」「話者識別」「発話終了制御」を行います。
実務上の最大インパクトは、サービス間のハンドオフ遅延と障害ポイントの削減です。1時間あたり約28.1円($0.18)という明確な単価設定により、コールセンターのリアルタイムモニタリングや会話型エージェントのインフラコストを予測・削減しつつ、システムアーキテクチャをシンプルに維持できます。
制約と前提の解体(落とし穴と現実の検証)
導入にあたり、エンジニアが把握しておくべき重大な制約が存在します。
- モデルウェイトの完全非公開: 本モデルはOSS(オープンソース)ではなく、Meta Model API上のプロプライエタリなサービスです。オンプレミス環境やローカルGPU(vLLM等)でのセルフホストは行えません。セキュリティ要件で音声データを外部クラウドへ送信できないプロダクション環境では採用を見送る必要があります。
- 動的レイテンシ(Adaptive Delay)への依存: 公表されているパレート境界(Pareto front)のベンチマーク性能は、強化学習(RL)を用いた動的レイテンシ制御(難解な語彙に対して自律的に遅延を調整する仕組み)に依拠しています。極端な超低遅延(例: 100ms以下固定)を厳格に要求するリアルタイム対話では、動的遅延による応答時間の不均一性が課題となる場合があります。
- 特定エッジケースでの話者識別精度: 最大20人以上の話者分離を謳うものの、複数人が同時に発話する「被り発話(Overlapping Speech)」における話者切り替えトークン(
<|speaker_{A-Z}|>)の精度低下は完全に克服されておらず、事後バッチ処理型の最適化モデルには及びません。
挙動とワークフローの差異(他モデルとの動作・安全性比較)
従来のASRパイプラインと Muse Voice Transcribe のトークン挙動および制御フローの差異は以下の通りです。
- 自己決定型リスニングループ: 入力チャンクごとに、モデルは
<|next_audio|>(追加音声の待機)を出力するか、テキストまたは制御トークンを生成するかを自己決定します。事前のVADルールベース処理が不要です。 - 明示的な構造化トークン: 発話開始は
<|speech_onset|>、発話終了は<|speech_endpoint|>、話者指定は遅延付与された<|speaker_A|>〜<|speaker_Z|>トークンで出力されます。 - エージェント連携での安全性: 従来の「VADが切れたら発話終了とみなす」タイムアウト判定と異なり、モデル自体が意味論的に発話の区切りを判断して
<|speech_endpoint|>を発行するため、言い淀み(「えーと」「はい」など)による早とちり応答を防止できます。
環境構築と最小実行コード(実装とクイックスタート)
本サービスはクラウドAPIとして提供されるため、ローカルGPUや大容量VRAMは不要です。以下は Python 用の公式 SDK を用いた WebSocket ストリーミング処理の最小実装例です。
import asyncio
import os
from meta_model_api import StreamingVoiceClient

API_KEY = os.getenv(