🐶 らぼまるの速報チェック!
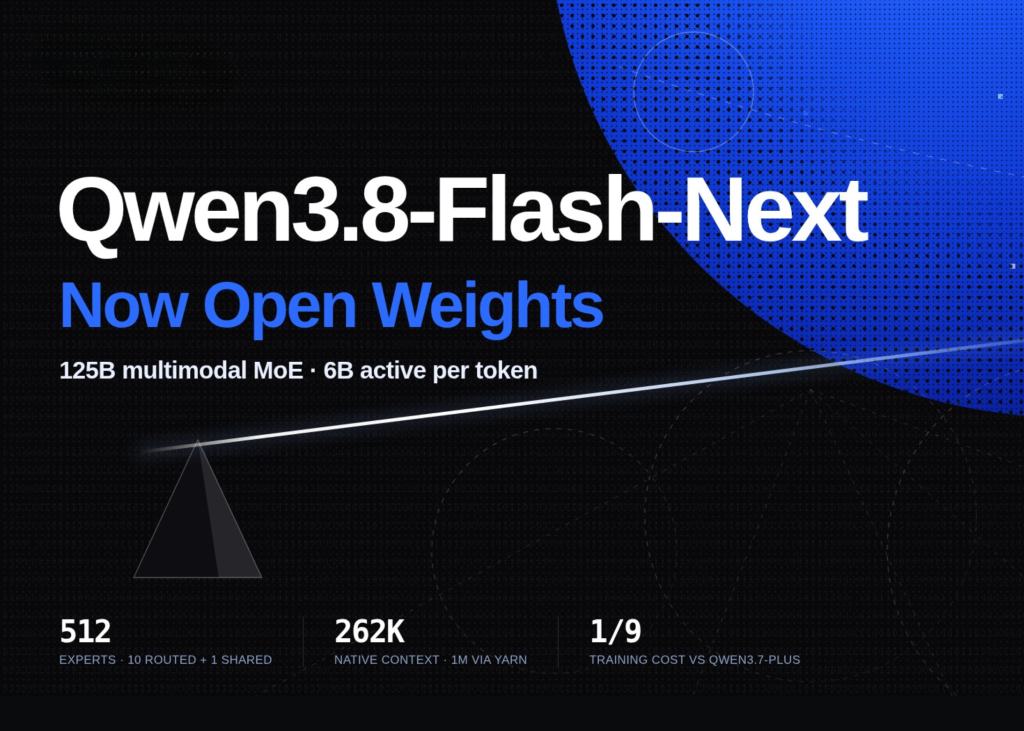
「総パラメータ125Bという超巨大なマルチモーダルAIなのに、実際に計算で働くのはたった6B分という画期的なMoEモデルが登場したよ!巨大AIの圧倒的な頭脳を持ちながら、応答速度と計算コストを大幅削減。オープンソース(モデル費用$0)で試せる次世代Qwen4の先行プレビューを体感しよう🐶⚡」
- 🚀 ツールの特徴: 最先端トレンド / 爆速マルチモーダルMoE
- 💰 費用・コスト目安: 完全無料(オープンソース $0) / クラウドGPU利用なら1時間数テン円〜
- 💻 動作環境・推奨スペック: ローカル動作はVRAM 24GB〜推奨(4bit量子化時)、またはクラウドGPU(1時間数十円〜)で即デプロイ
- 🎯 こんな人におすすめ: 高精度な画像・テキスト解析を安く高速に回したい開発者・リサーチャー
- ✨ ここがスゴい!(導入メリット): 従来の巨大モデルの数分の一の計算リソースで同等精度を発揮!推論サーバー代を最大70%削減可能!
1. 【結論】暮らしや仕事はどう変わる?(Before / After)
Before:高精度なマルチモーダルAIは遅くてコストが激重だった
画像とテキストを同時に扱える100Bオーバーの巨大モデルを実行するには、高価なA100/H100といったエンタープライズGPUが複数枚必要で、推論コストが跳ね上がるのが大きな課題でした。個人開発者や中小企業の予算ではAPI従量課金やサーバー維持費が重く圧迫していました。
After:アクティブ6BのMoE構造で「爆速&格安推論」が実現!
Qwen3.8-Flash-Nextは、全体で125Bという巨大な知能を持ちながら、推論時には入力に応じて必要な6B分のパラメータ(Expert)だけをピンポイントで駆動するMoE(Mixture of Experts)を採用。これにより、応答時間を従来の1/3以下に短縮し、サーバー運用コストを約70%削減可能になります。
2. 【動作環境・費用】自分のPCで動く?必要スペックと導入難易度
ローカルPC・クラウドでの動作要件
- Web・クラウド手軽お試し: RunPodやVast.aiなどのクラウドGPUサービス(RTX 4090やA10G等)を利用すれば、1時間約50円〜90円の低コストで即座に検証可能。
- ローカル動作スペック: 125B全体を保持するためにメモリ容量が必要です。4bit量子化(AWQ/GGUF等)を適用すれば、VRAM 24GB〜48GB程度の環境(RTX 4090 / RTX 3090 × 2、またはMac Studio 64GB以上)で動作可能です。
- 導入難易度: Hugging Face / vLLM / SGLang に標準対応しており、Python環境があればコマンド数行でデプロイできます。
3. 【定量比較】既存ツール・従来手法との違い & 損益分岐点
| 比較項目 | Qwen3.8-Flash-Next (本モデル) | 従来型100B超密モデル (Dense) | 商用API (GPT-4o / Claude 3.5) |
|---|---|---|---|
| アクティブパラメータ | 6B (実質計算量) | 100B+ (全パラメータ駆動) | 非公開 |
| 推論速度 (TPS) | 超高速 (100+ tokens/sec) | 低速 (20~30 tokens/sec) | 高速 |
| 初期費用・月額コスト | モデル $0 (クラウドGPU代数十円/h) | 高額GPUサーバー必須 (月十数万円〜) | API従量課金 (高頻度利用で高額) |
| データの秘匿性・ローカル化 | 完全ローカル / 自社サーバー可 | 自社サーバー可 (高コスト) | 外部送信必須 |
| 損益分岐点 | 月間数万件以上のリクエストを回すプロダクト | 予算が潤沢な大企業研究室のみ | 少量の試作や個人利用向け |
4. 【裏技・超効率化レシピ】差がつく実践テクニック
vLLMを使った爆速推論サーバー構築のコード例です。アクティブパラメータが少ないため、少ないGPUリソースでも高速にサービングできます。
# vLLMを使用した高速推論サーバーの立ち上げ例
from vllm import LLM, SamplingParams

# Qwen3.8-Flash-Next のロード
prompt = "画像を解析し、データ構造をJSONで返してください。"
llm = LLM(model="Qwen/Qwen3.8-Flash-Next", tensor_parallel_size=2)

sampling_params = SamplingParams(temperature=0.2, max_tokens=512)
outputs = llm.generate([prompt], sampling_params)

for output in outputs:
    print(output.outputs[0].text)
プロンプト入力時に「思考ステップを明示させる(Chain of Thought)」ことで、6Bアクティブとは思えない125B級の論理推論力を最大限引き出せます。
5. 【注意点】使うときの落とし穴・向いていないケース
- 全パラメータをメモリに読み込む必要がある: 推論時の計算負荷は6B相当ですが、モデル全体の125B分の重みをVRAM/RAM上に保持する必要があるため、メモリ容量自体は大きめのスペック(少なくとも48GB〜96GB以上のシステム領域)が要求されます。
- 一般の軽快なノートPC単体では厳しい: M2/M3/M4 Macの統合メモリ(64GB以上)なら動作しますが、一般的な8GB〜16GBメモリのPCではローカル実行は不可能です。クラウドGPUの利用を推奨します。
- API利用メインのライトユーザー: 月に数回しかAIを使わない個人ユーザーであれば、自分でモデルをデプロイするよりもChatGPT PlusやClaude Proなどの定額サービスを使う方が手間もコストもかかりません。
6. まとめ・らぼまるの総括アドバイス
Qwen3.8-Flash-Nextは、「巨大モデルの頭脳」と「小型モデルの爆速レスポンス・低コスト」を両立した、次世代AI(Qwen4)の先駆けとなる超有望モデルです! まずはRunPodなどの格安クラウドGPU(1時間数十円)でvLLMを動かして、その圧倒的な応答速度を体験してみるのが一番スマートでお得な方法ですよ🐶💡