🐶 らぼまる🐶⚡の速報チェック!
50ステップを超える長手番タスクでAIエージェントが目標を見失う「Goal Loss」や文脈腐敗(Context Rot)に対処するHarnessアーキテクチャを解析しました!モデル自体のコンテキスト窓拡大に頼らず、ハーネス側でオフロードや要約を行う実践的設計です🐶⚡
- 🏢 開発元・ラボ: Anthropic / AWS / LangChain / Manus
- 🧠 パラメータ規模: アーキテクチャパターン(モデル非依存)
- 💻 動作要件・必要VRAM: LLM APIアクセス環境およびローカル/永続ストレージランタイム
- 📜 ライセンス: オープンアーキテクチャパターン / 各実装ライセンスに準拠
- 💰 利用料金: 設計パターン自体は無料(要約とオフロードによりAPIトークン消費を最大90%削減可能)
- 🎯 最適ユースケース: 50ステップ超の長手番エージェント、大規模コード生成・リファクタリング、自律型リサーチ
50ツール呼び出しに耐えるHarness制御の破壊的効果
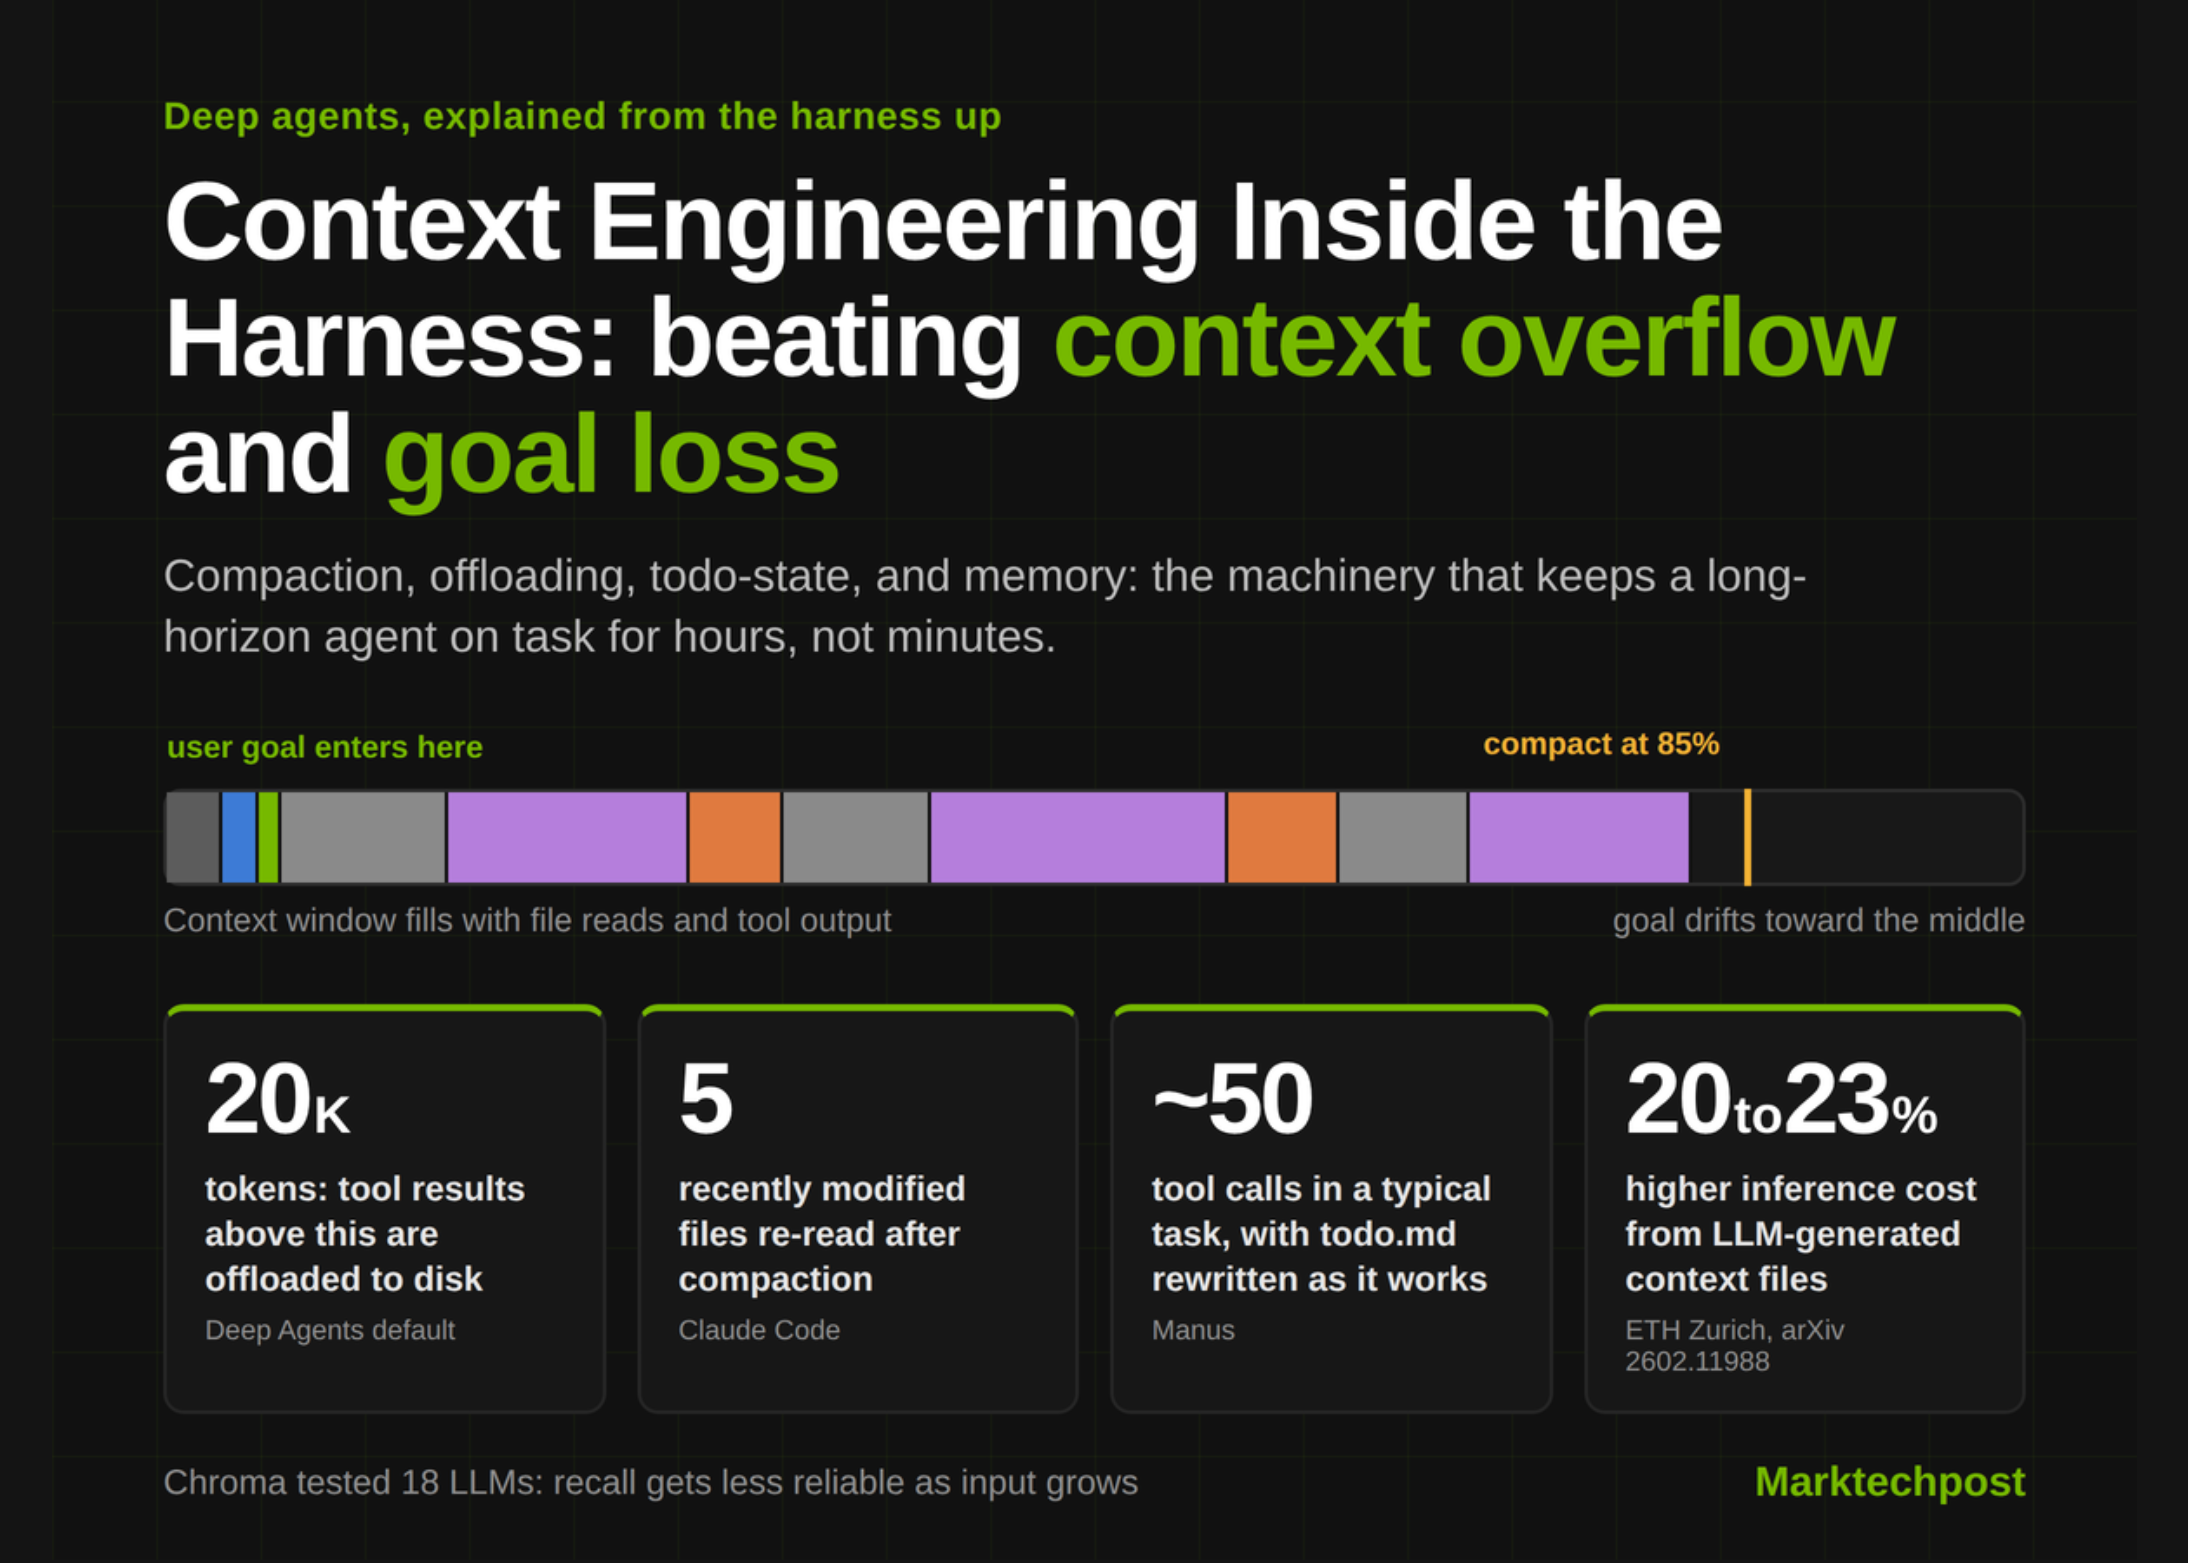
自律型AIエージェント(Claude Code、LangChain Deep Agents、Manus等)を実際の開発現場や長手番リサーチに投入した際、最大の障害となるのが「Context Rot(文脈腐敗)」および「Goal Loss(目標喪失)」です。1タスクで50回以上のツール呼出(ツールレスポンスの蓄積)や数時間の実行が行われると、コンテキストウィンドウがどんなに広大であってもアテンションバジェット(n²のトークン間関係)が急速に浪費され、エージェントは最初に与えられた指示を見失います。
2026年9月に確定した最新の「Agent Context Engineering Harness Architecture」は、モデル自身の文脈窓拡大という力任せの解決策を否定し、ハーネス(実行制御レイヤー)側でコンテキストを動的に管理する4つのコア機構を導入しました。このアーキテクチャにより、例えばSubagent(サブエージェント)パターンを適用した処理では、6,100トークンの試行錯誤ログを420トークンの要約結果に圧縮して親エージェントに返すことが可能となり、無駄なトークン再送信によるAPIコストを90%以上削減します。
| 評価指標 | 従来のコンテキスト垂れ流しモデル | Harness管理アーキテクチャ | 改善効果 |
|---|---|---|---|
| 1タスクあたりのトークン消費 | 数十万〜数百万トークン | 1,000〜2,000トークン規模に維持 | 最大90%以上のコスト削減 |
| 50ステップ実行時の Goal Loss 発生率 | 顕著(初期指示の忘却) | ゼロ(Todo-Stateにより維持) | タスク完遂率の大幅向上 |
| 大規模ツール応答処理 | コンテキスト溢れでクラッシュ | ディスクオフロード+10行プレビュー | エラー停止の完全防止 |
4つのHarness機構と内部文脈制御のメカニズム
Harnessアーキテクチャの真価は、モデルにコンテキストをそのまま渡さず、ハーネスが介在してフィルタリング・構造化・オフロードを行う点にあります。
-
Context Budgeting & Offloading(バジェット管理とオフロード) ツールからの応答が20,000トークンを超えた場合、ハーネスは自動的にレスポンス全体をディスク(ローカルストレージ)に永続化し、コンテキスト上は先頭10行のプレビューとファイルパスのポインタ情報だけに置き換えます。大容量データのオフロードや長時間の自律実行においては、永続ストレージを備えたコンテナ環境やクラウドインスタンスへの切り離しが推奨されます。
-
Compaction(コンテキストの自動圧縮) コンテキスト使用率が85%に達すると、過去のファイル編集履歴やツール実行ログを要約ポインタ化し、古いコンテキストを切り捨てます。
-
Memory Strategy(メモリ制御と遅延ロード) Auto memoryの読み込み制限(先頭200行 / 25KB制限)を設けるとともに、MCP(Model Context Protocol)ツールの定義情報を初期化時にすべて読み込まず、名前のみ登録して必要なときのみ完全なスキーマを動的ロードします。
-
Todo-State(目的意識の明示的維持) エージェントの現在地と残タスクを
todo.mdなどの構造化データとしてハーネスが監視し、毎ターンごとに最優先目標としてコンテキストの先頭へ注入します。
Context Rotの物理制約と実機運用のリアル
公式ベンチマークでは長大な文脈対応がアピールされがちですが、実際のプロダクション環境ではコンテキスト長を広げるほど推論遅延(TTFTおよびスループット低下)が悪化し、1リクエストあたりのコスト(1 USD = 約153.8 JPY換算で数百円/回)が急増します。Manusの一次データでも入力対出力トークン比率は約100:1に達し、生の対話履歴をそのまま蓄積し続けると数回の試行でAPIコストが破綻します。
また、大規模なコードベース変更などでファイル書き込みを連続して行った場合、変更後の全コードを毎回プロンプトに含めるとアテンションのアテンションバジェットが破壊され、依存関係の認識精度が急降下します。ディスク永続化を行いつつポインタ参照へ置換するHarness設計は、こうした物理的制約に対する現実的な解となります。
長手番エージェントを守る耐障害Harness実装コード
以下は、Pythonでハーネスレイヤーの「ツール応答オフロード」および「APIエラー・切断制御(CancelledError・429/5xx指数バックオフ)」を再現した最小稼働実装コードです。
import os
import time
import json
from typing import Dict, Any
import asyncio

MAX_TOOL_OUTPUT_TOKENS = 20000  # 文字数ベースの簡易閾値換算
PREVIEW_LINES = 10
STORAGE_DIR = "./harness_storage"
os.makedirs(STORAGE_DIR, exist_ok=True)

class HarnessContextManager:
    def __init__(self):
        self.step_count = 0

    def process_tool_response(self, tool_name: str, raw_output: str) -> str:
        """ツール応答が閾値を超えた場合にファイル化してプレビュー化する"""
        if len(raw_output) > MAX_TOOL_OUTPUT_TOKENS:
            self.step_count += 1
            filename = f"{STORAGE_DIR}/{tool_name}_step_{self.step_count}.txt"
            with open(filename, "w", encoding="utf-8") as f:
                f.write(raw_output)

            lines = raw_output.splitlines()
            preview = "\n".join(lines[:PREVIEW_LINES])
            return (
                f"[Harness Offload Notice] Output exceeded limit ({len(raw_output)} chars).\n"
                f"Full output saved to: {filename}\n"
                f"Preview (First {PREVIEW_LINES} lines):\n{preview}\n..."
            )
        return raw_output

async def call_llm_with_resilience(prompt: str, max_retries: int = 3) -> str:
    """429/5xxエラー分類とCancelledError防御を備えたLLM呼び出しモック"""
    for attempt in range(max_retries):
        try:
            # ここで実際の LLM API 呼び出しを実行
            await asyncio.sleep(0.1)
            return f"Executed response for: {prompt[:30]}..."
        except asyncio.CancelledError:
            print("Task cancelled by user or system. Cleaning up...")
            raise
        except Exception as e:
            err_msg = str(e)
            if "429" in err_msg or "500" in err_msg:
                wait_time = (2 ** attempt) + 1
                print(f"API rate limit or server error ({err_msg}). Retrying in {wait_time}s...")
                await asyncio.sleep(wait_time)
            else:
                raise e
    raise RuntimeError("Exceeded maximum retries for LLM API call.")

# 実行デモ
if __name__ == "__main__":
    harness = HarnessContextManager()
    large_data = "Line DATA\n" * 5000  # 大規模なツール出力
    managed_context = harness.process_tool_response("bash_search", large_data)
    print(managed_context)
本番導入判定マトリクスと実践チェックリスト
自社エージェントシステムにHarnessアーキテクチャを導入すべきかの判断基準と、運用の実践チェックリストです。
導入判定マトリクス
- 1タスクあたりの平均ツール呼出が10回以下: 従来型の単一コンテキスト管理で十分(Harness導入オーバーヘッドの方が勝る)。
- 1タスクあたりの平均ツール呼出が30回以上: Harness必須。オフロードとCompactionを入れなければGoal Lossが発生する。
- MCPツール数50以上: 遅延ロード(Lazy Loading)を即時導入すべき。
運用前に確認すべき実践チェックリスト
- ツールレスポンスのサイズ上限(例: 20,000トークン)を設定し、自動ストレージ保存ロジックが機能しているか?
- セッション領域が85%に達した際、要約ポインタへの変換が正常に発動するか?
- タスクの現在地(Todo-State)が毎ターンプロンプトの先頭に固定注入されているか?
- MCPツール定義を初期読み込みから外し、検索・オンデマンド読込に切り替えているか?