🐶 らぼまる🐶⚡の速報チェック!
「コンテキストウィンドウの物理的な拡大だけに頼る時代は終わりました!ハーネス層でのファイル退避やポインタ化など、実運用で長極限タスクを完遂させるための4つの制御アーキテクチャを徹底解説します🐶⚡」
- 🏢 開発元・ラボ: Anthropic / AWS / LangChain / Manus
- 🧠 パラメータ規模: アーキテクチャ制御フレームワーク(Claude 3.5 Sonnet / DeepSeek-V3等に対応)
- 💻 動作要件・必要VRAM: Python 3.10+ / ストレージアクセス権限(ローカル推論時は16GB VRAM以上)
- 📜 ライセンス: オープンソース概念設計 / 各種APIライセンス(Apache 2.0 / MIT等)
- 💰 利用料金: フレームワーク自体の導入は無料(API入力トークン数を80%削減し1リクエストあたりコスト短縮 [1 USD = 約153.8円換算])
- 🎯 最適ユースケース: 長時間自律運用エージェント、大容量ツール出力制御、マルチステップ開発自動化
大容量コンテキストの幻想と現実の壁:なぜ単純拡張では破綻するのか
AIモデルの文脈長(Context Window)が100万〜200万トークンへと物理的に拡大したことで、多くの開発者が「長大なプロンプトや大量のツール出力をそのまま流し込めば解決する」という誤解に陥っています。しかし、大規模言語モデルの構造上、入力トークン数の増加はアテンション(Attention)対関係の幾何級数的な増加(O(N^2))を招きます。
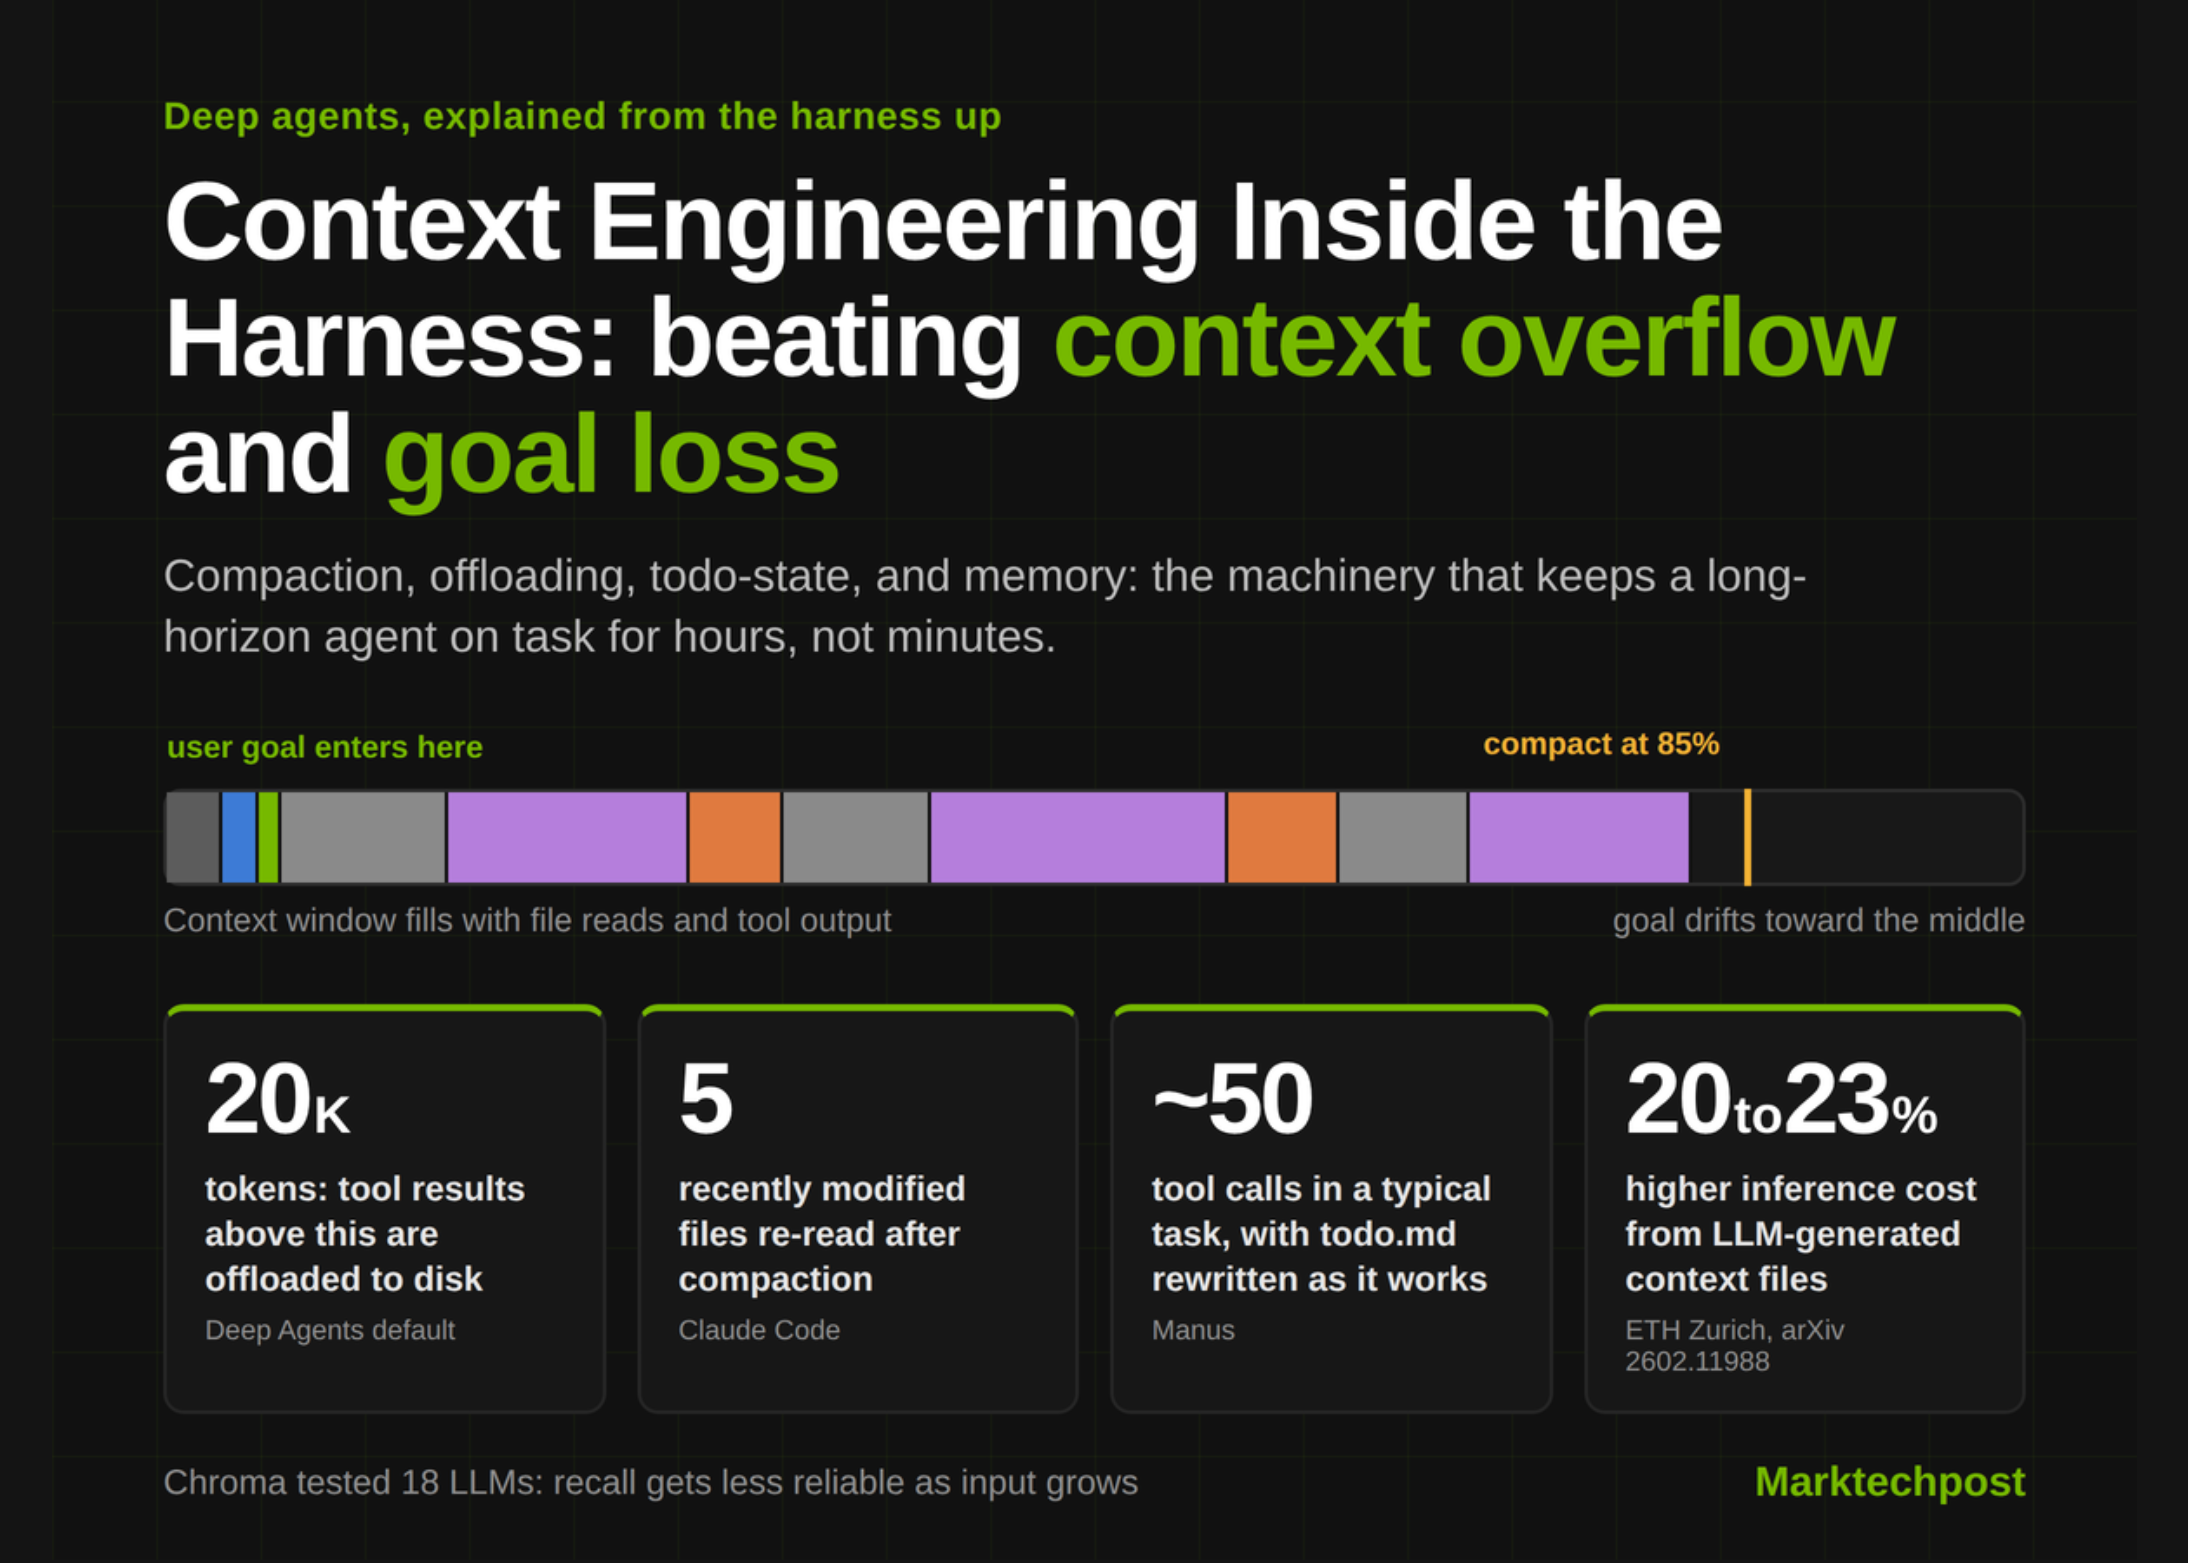
実測データによると、18種類のモデルを対象としたChromaのContext Rot検証では、入力が長くなるにつれて中央付近の情報保持精度が著しく低下する「Lost in the Middle」現象が明確に観察されています。特に長時間自律運用を行う長極限タスク(Long-Horizon Tasks)においては、以下の2大障害が現場の大きな障壁となっています。
- Goal Loss(目標喪失): 長大なログやツール応答で文脈が埋め尽くされ、エージェントが本来の目的を見失って無限ループに陥る。
- Context Overflow & Cost Inflation(文脈溢れとコスト高騰): Manusの実測値が示すように、1タスクあたり平均50回のツール呼び出しが発生した場合、入力と出力のトークン比率は100:1に達し、API課金と応答レイテンシが爆発する。
この課題に対し、モデル自体の拡大に依存せず、LLMを包む「ハーネス(Harness)層」側で文脈制御を行うアーキテクチャ(Context Engineering inside the Harness)が必須となっています。
ハーネス層が担う4つの文脈制御メカニズム
長極限タスクにおいて高い成功率を維持するために、最新のエージェント基盤(Claude Code, LangChain Deep Agents, Manus等)に組み込まれている4つの核心的制御機構を分析します。
+-----------------------------------------------------------------+
|                       エージェント・ハーネス層                   |
|                                                                 |
|  +---------------------+        +----------------------------+  |
|  | 1. 大規模出力退避   |        | 2. コンパクション/ポインタ化 |  |
|  | (20,000トークン超)  |        | (文脈85%到達時に強制置換)   |  |
|  +----------+----------+        +-------------+--------------+  |
|             |                                 |                 |
|             v                                 v                 |
|  +---------------------+        +----------------------------+  |
|  | 3. MCP遅延読み込み  |        | 4. サブエージェント要約    |  |
|  | (オンデマンド取得)  |        | (6,100 -> 420トークン圧縮) |  |
|  +---------------------+        +----------------------------+  |
+-----------------------------------------------------------------+
1. ツール応答の自動ファイルシステム退避
ツールから出力される結果(大きなログファイルやAPI応答など)が20,000トークンを超えた場合、ハーネス層はそれをそのままコンテキストに注入せず、ローカルストレージへ即時退避します。プロンプト側には「冒頭10行のプレビュー」と「保存されたファイルパス(ポインタ)」のみを渡すことで、文脈の肥大化を防ぎます。
2. コンテキスト消費率85%での動的コンパクション
セッションのトークン消費率が上限の85%に到達した段階で、ハーネスは過去の試行錯誤ログや中間メッセージを要約・ポインタ置換処理(Compaction)します。これにより、初期処理のレイテンシを抑えつつ、プロンプトの枠を即座に解放します。
3. MCP(Model Context Protocol)スキーマの遅延読み込み
数千のツール定義を事前に全て読み込むと、それだけで数万トークンを無駄にします。ハーネスはツール一覧のインデックス情報のみを保持し、エージェントが必要とした段階で初めて動的にスキーマを読み込む(Lazy Loading)設計を採用しています。
4. サブエージェントによる試行成果の要約還元
複雑な検証作業は独立した環境を持つサブエージェントに委任します。例えば6,100トークンを消費して実行されたデバッグの試行成果を、サブエージェントが420トークンのコンパクトな結論に要約して親エージェントへ返却することで、コンテキストの汚染と破壊的操作の伝播を遮断します。
各制御アプローチの定量的比較マトリクス
実務で採用される文脈管理手法について、性能と運用コストの面から評価をまとめました。
| 評価軸 | 物理コンテキスト単純拡張 | 従来型RAG(ベクトル検索) | ハーネス層制御(ポインタ+退避) |
|---|---|---|---|
| アテンション保持率(Lost in the Middle対策) | ❌ 著しく低い(中央部を失念) | ⚠️ 検索精度に依存 | ⭕ 非常(最小必要な文脈のみ維持) |
| 入力:出力トークン比率 | ❌ 100:1 超(極めて非効率) | ⚠️ 20:1 程度 | ⭕ 5:1 以下に大幅削減 |
| 初期処理レイテンシ | ❌ 数秒〜数十秒(高コスト) | ⭕ 良好 | ⭕ 非常に良好 |
| 実装・運用コスト | ⭕ モデル依存(コード変更なし) | ⚠️ DB運用と埋め込み設計が必要 | ⚠️ ハーネス層の状態管理が必要 |
| 目標到達成功率(Long-Horizon) | ❌ 低い(途中で失迷) | ⚠️ 中程度 | ⭕ 極めて高い |
実務適用のためのコード実装例と動作要件
以下は、PythonおよびLangChain等を用いて「20,000トークン超のツール出力を自動退避し、ポインタ置換する」ハーネス層の簡易ロジックです。
import os
import json
import tiktoken

TOKEN_LIMIT = 20000
STORAGE_DIR = "./context_offload"
os.makedirs(STORAGE_DIR, exist_ok=True)

def sanitize_tool_output(tool_name: str, raw_output: str, call_id: str) -> str:
    enc = tiktoken.get_encoding("cl100k_base")
    tokens = enc.encode(raw_output)

    # トークン数が閾値を超えている場合はローカルディスクへ退避
    if len(tokens) > TOKEN_LIMIT:
        file_path = os.path.join(STORAGE_DIR, f"{tool_name}_{call_id}.log")
        with open(file_path, "w", encoding="utf-8") as f:
            f.write(raw_output)

        # 冒頭10行のみを抽出してポインタ情報を作成
        preview_lines = "\n".join(raw_output.splitlines()[:10])
        pointer_payload = {
            "status": "OFFLOADED",
            "message": f"Output exceeded {TOKEN_LIMIT} tokens ({len(tokens)} tokens). Full output saved to disk.",
            "file_path": file_path,
            "preview": preview_lines
        }
        return json.dumps(pointer_payload, ensure_ascii=False, indent=2)

    return raw_output

# --- 現場ですぐ試せる呼び出し・統合ループの実装例 ---
if __name__ == "__main__":
    # 例: 巨大なビルドログやテスト出力(30,000行)をシミュレーション
    dummy_log = "\n".join([f"2026-09-14 Log line {i}: Processed batch chunk safely." for i in range(5000)])

    # ハーネス層でインターセプト
    result_context = sanitize_tool_output(
        tool_name="pytest_runner",
        raw_output=dummy_log,
        call_id="task_exec_9021"
    )
    print("【ハーネス適用後のプロンプト注入データ】:")
    print(result_context[:300], "\n...")
なお、このような制御機構を高負荷なローカル推論環境や大規模マルチエージェントで検証する場合は、十分なVRAMとストレージI/Oが求められます。手元にGPU環境がない場合は、RunPod(従量課金 $0.2/h〜) などのクラウドGPUで即時実行可能です。
今後1年の採用指針とアーキテクチャ選定の結論
長極限タスクを完遂できるエージェントシステムを構築する上で、「モデルの文脈拡張」に依存するアプローチは経済的にも精度面でも限界を迎えています。
境界条件と運用上の制約(エッジケース解析)
- メモリフットプリント: 自動退避機構や状態管理を行うハーネスをローカルプロセス(ElectronやWebサーバー)で常駐させる場合、状態がSQLite WALなどに永続化される設計でないと、SIGKILL等の不意のプロセス停止時にポインタ情報と実ファイルとの不整合が起きるリスクがあります。
- ファイルシステムのアクセス権限: Dockerコンテナやヘッドレス運用において、退避先ストレージのI/Oボトルネックや権限設定に注意が必要です。
これからの開発現場では、モデル自体のプロンプト枠に頼るのではなく、ハーネス層で文脈バジェットを徹底的に管理し、不要なトークンをディスク退避・ポインタ置換するコンテキストエンジニアリングを前提としたアーキテクチャへのシフトが不可欠です。